#ШІ

Новий метод, який перетворює довгий контекст на дерево підсумкових даних

Впровадження архітектури трансформерів завдяки механізму самонавчання, збільшенню розміру моделі та обсягу даних для попереднього навчання значно покращило роботу з великими мовними моделями.

Дослідники мета ШІ представили розшифровку сприйняття мови з неінвазивних записів мозку

Розшифровка розмовної мови за активністю мозку — давнє прагнення в галузі охорони здоров'я та нейронаук — досягла значного прогресу завдяки використанню інвазивних пристроїв. Алгоритми глибокого навчання, навчені на внутрішньочерепних записах, продемонстрували здатність розшифровувати основні лінгвістичні елементи.

Генерування зображень у контексті з мультимодальними LLM

Останні досягнення значно покращили генерацію зображень з текстових описів і синтез нових зображень шляхом поєднання тексту і зображень. Однак з'явився новий рубіж: генерування зображень з узагальнених вхідних даних мовою технічного зору, особливо тих, що включають складні описи сцен з багатьма об'єктами і людьми.

Швидший та ефективніший метод дистиляції для перетворення тексту в зображення

Моделі дифузії текст-зображення, навчені на великих наборах даних, стали домінуючою силою в генеративних задачах, оскільки вони дають високоякісні та різноманітні результати. Останнім часом ці моделі застосовують для задач перетворення зображень, таких як зміна, покращення або надвисока роздільна здатність зображень, керуючи згенерованими результатами за допомогою дифузії.

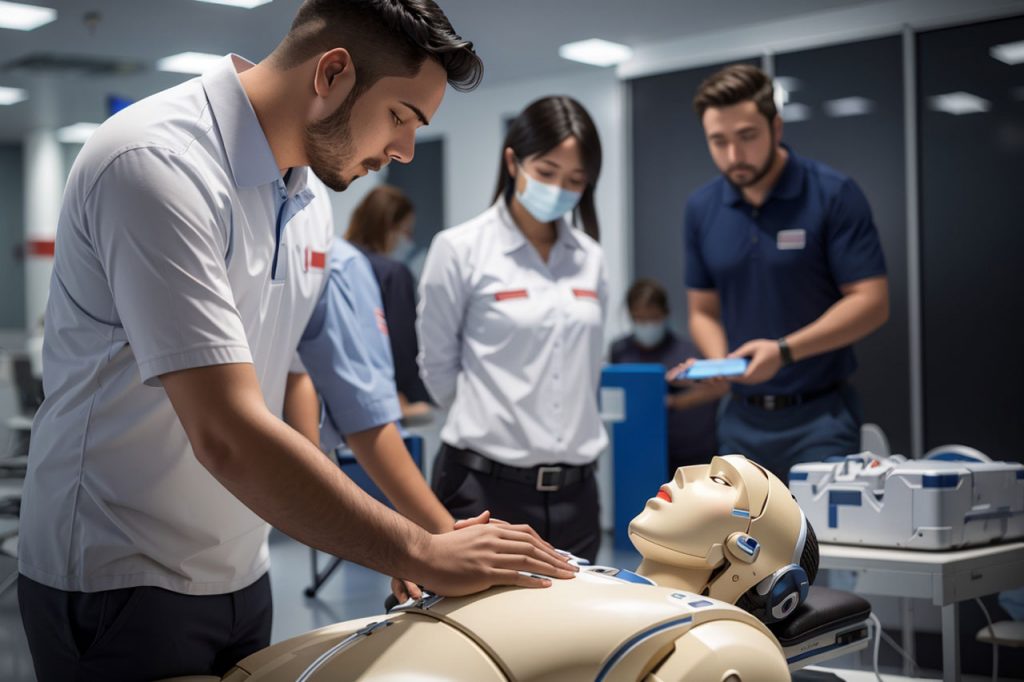
Використання штучного інтелекту в навчанні серцево-легеневої реанімації

Серцево-легенева реанімація (CPR) — це життєво важлива медична процедура, яка застосовується у разі зупинки серця, що характеризується раптовим припиненням ефективного серцебиття або дихання.

Мультиагентний підхід до моделювання трафіку

Авторегресійні мовні моделі продемонстрували свою здатність передбачати наступне підслово в реченні, не покладаючись на заздалегідь визначену граматику чи правила синтаксичного аналізу. Цей підхід було поширено на області безперервних даних, такі як генерація аудіо та зображень, де дані представлені у вигляді дискретних токенів, подібно до словників,…

Вдосконалення мовних моделей за допомогою підказок до аналогій для покращення міркувань

Останніми роками мовні моделі продемонстрували вражаючі навички розуміння та генерування тексту, подібного до людського. Однак, незважаючи на їхні чудові мовні можливості, ці моделі часто відстають у складних міркувальних завданнях.

Чи можемо ми довірити ШІ нанесення водяних знаків?

Стрімкий розвиток генеративного штучного інтелекту відкрив нову еру створення цифрового контенту, але він також несе з собою значні виклики, особливо в ідентифікації та відстеженні контенту, створеного штучним інтелектом.

BrainChip запускає платформу Akida другого покоління для вдосконалення ШІ

В епоху постійно зростаючого інтересу до можливостей штучного інтелекту (ШІ) компанія BrainChip, першопроходець у галузі нейромережевих процесорів, зробила значний крок вперед, забезпечивши периферійні пристрої безпрецедентними обчислювальними потужностями.

Подолання галюцинацій в ШІ

Завдяки додатковому попередньому навчанню з використанням пар зображення-текст або точному налаштуванню за допомогою спеціалізованих наборів даних з візуальними інструкціями, великі мовні моделі можуть перейти в область мультимодальних можливостей, прокладаючи шлях до надійних великих мультимодальних моделей.

Мультимодальний мовний асистент із зоровими та слуховими сенсорами від Reka AI

Попит на просунуті та універсальні мовні асистенти у світі штучного інтелекту, що постійно розвивається, продовжує зростати. Одна з головних проблем полягає у створенні дійсно мультимодальної системи штучного інтелекту, здатної безперешкодно розуміти та взаємодіяти з текстом, візуальними та слуховими даними.