 Штучний Інтелект
Ефективність ШІ змінює виробництво напівпровідників і ланцюги постачання
Штучний інтелект — найсуттєвіша зміна, з якою зіткнулася напівпровідникова галузь. Не лише тому, що він спричиняє черговий цикл зростання, а й тому, що змінює спосіб роботи всієї індустрії.
Галузь уже переживала масштабні трансформації. Мобільні технології та інтернет змінили те, що продавали виробники напівпровідників, але не перебудували роботу фабрик, безфабричних компаній і їхніх постачальників. ШІ робить і те, й інше: створює безпрецедентний попит на кремнієві чипи та водночас змінює інструменти, дані й моделі співпраці в розробленні, виробництві та тестуванні.
Близько чотирьох років тому, коли з’явився ChatGPT, ми почали переосмислювати портфель продуктів, спираючись на принцип «ШІ понад усе». Результатом стала платформа нового покоління, що об’єднує три напрями нашої роботи. Перший — прискорення виходу на цільовий рівень виходу придатних виробів для нових технологій; другий — застосування новітніх ІТ-рішень до виробничих даних. Третій — об’єднання виробничих операцій у ланцюгу постачання, напрям, який посилило придбання secureWISE у 2025 році.
Сьогодні ключове слово — ефективність. Керівник виробництва нещодавно сказав постачальникам, що не може отримати більше обладнання, ніж уже було обіцяно. Єдиний спосіб задовольнити попит — ефективніше використовувати наявні потужності. Таку думку нині можна почути в усій галузі. Вона відображає три виклики, які ШІ ставить перед виробництвом напівпровідників:
- Енергоефективність: отримувати більше від ШІ-датацентрів, які будують.
- Ефективне використання даних і обчислень: здобувати корисні висновки з виробничих даних за прийнятну ціну.
- Ефективність ланцюга постачання: керувати глобальним і дедалі складнішим ланцюгом.
Виклик 1. Енергоефективність
Масштаб майбутнього зростання вже не викликає сумнівів: напівпровідникова галузь досягла обсягу в трильйон доларів раніше, ніж прогнозували. За базовим сценарієм McKinsey & Company, дохід від пристроїв зросте з 975 млрд доларів у 2025 році приблизно до 2,3 трлн доларів у 2030-му. Це означатиме збільшення обсягу на 83,5%; 58% приросту припаде на датацентри й сервери — єдиний сегмент, що зростає на 29% щороку.
Якщо перевести ці показники у фізичні потужності, масштаб стає наочнішим. Встановлена потужність ШІ-датацентрів, яка у 2026 році становитиме 45–60 ГВт, за прогнозом, досягне 100–160 ГВт у 2030-му. За розрахунком 150 000–200 000 пластин на гігават, половина з яких припадає на HBM, це означає потребу ще у 9,6–17,5 млн пластин і 16–29 нових фабриках, кожна з яких оброблятиме 50 000 пластин на місяць. Оцінка може бути заниженою: нині компанії не будують передові фабрики на 50 000 пластин. Сучасна фабрика передової логіки обробляє близько 20 000 пластин на місяць, тож фактична кількість потрібних фабрик може бути вдвічі більшою.
Якщо дохід від ШІ у 2030 році сягне прогнозованих 3,9 трлн доларів, а маржа становитиме близько 30 млн доларів на мегават, ці цифри можуть здаватися передусім проблемою капіталовкладень. Держави бачать їх і доходять висновку, що можуть оплатити будівництво. Але кожен, хто керував фабрикою, знає: нові потужності — лише частина відповіді. Складніше — отримати більше обчислень із кожного датацентру.
Цей тиск уже змінює галузь, а ефективність зростає завдяки новим архітектурам. Раніше більшість наших нових клієнтів були з Азії, де створювали фабрики й безфабричні компанії. Тепер компанії, що розробляють фундаментальні моделі, і гіперскейлери проєктують власні чипи, ставлячи енергоефективність на перше місце. Робочі навантаження також оптимізують. Під час навчання чип працює на проєктній потужності, тоді як GPU для інференсу може витрачати понад 90% енергії на оновлення пам’яті й простоювання.
За цим мірилом, у галузі залишається приблизно мільйонразовий запас для підвищення ефективності — таку оцінку пов’язують із лекціями Річарда Фейнмана про фундаментальні межі обчислень, прочитаними у 1980-х роках.
Що це означає для виробників
Раніше безфабричні компанії не могли виправдати інвестиції у виробниче програмне забезпечення, адже самі не були виробниками. Тепер вони ними стали. Значна частина змін у галузі відбувається після того, як пластина залишає фабрику передових технологічних процесів.
Кілька прикладів показують, як швидко змінюється виробництво. Енергоефективні спеціалізовані розробки створюють додаткові вимоги до виробництва й тестування: обсяги випуску окремих продуктів менші, а самих продуктів більше. Замість кількох виробів масового виробництва з’являється дедалі більше кастомізованих чипів.
Ширший спектр тестування нових продуктів переноситься у виробництво, де потрібне прискорене нарощування виходу придатних виробів, робота з ширшими наборами даних і тестовими програмами, що містять мільйони пунктів.
Нові технології, як-от спільне корпусування оптики з чипами та подібні інтеграції, означають, що виробничою лінією рухаються не лише електрони. Для цього потрібні нові засоби контролю процесів.
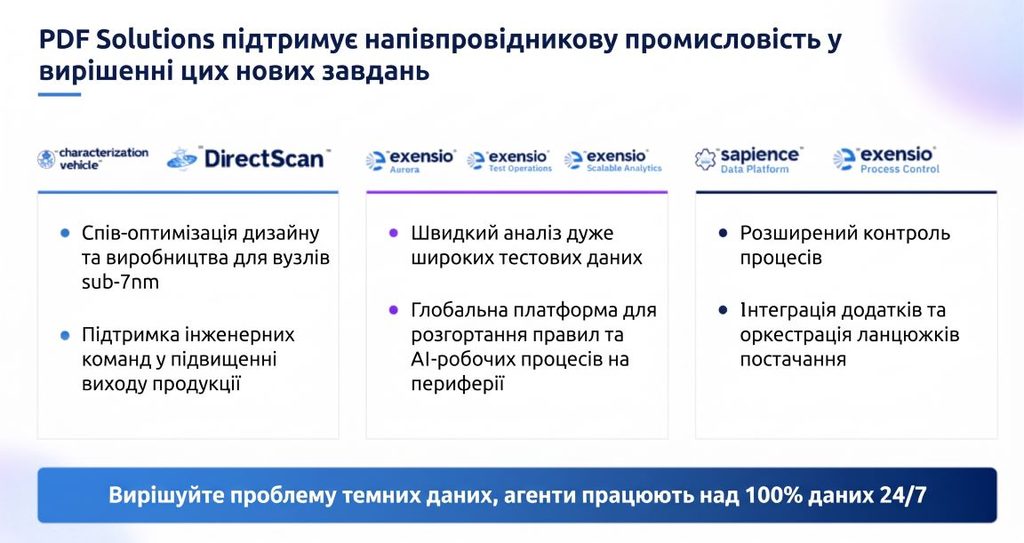
У портфоліо компанії PDF Solutions містяться рішення, що дозволяють подолати ці виклики. Виробництво та проектування на рівні менше 7 нм забезпечуються за допомогою систем Characterization Vehicle та DirectScan: вони використовують більше проєктної інформації, щоб визначити, де і як шукати дефекти, зокрема систематичні приховані дефекти у 3D-структурах за допомогою електронно-променевих технологій. Exensio Aurora, Exensio Test Operations і Exensio Scalable Analytics призначені для швидкого аналізу широких тестових даних, а також розгортання правил і ШІ-процесів на периферії. Обчислювальний рушій, побудований насамперед навколо Python і з паралельним виконанням, переносить аналіз із клієнтського пристрою до масштабованої серверної частини. За однакових витрат на обладнання це забезпечує у 20–40 разів вищу продуктивність завдяки ефективнішому використанню ядер. Sapience та Exensio Process Control розширюють можливості передового керування процесами, інтеграції застосунків і координації ланцюга постачання.
Виклик 2. Ефективне використання даних і обчислень
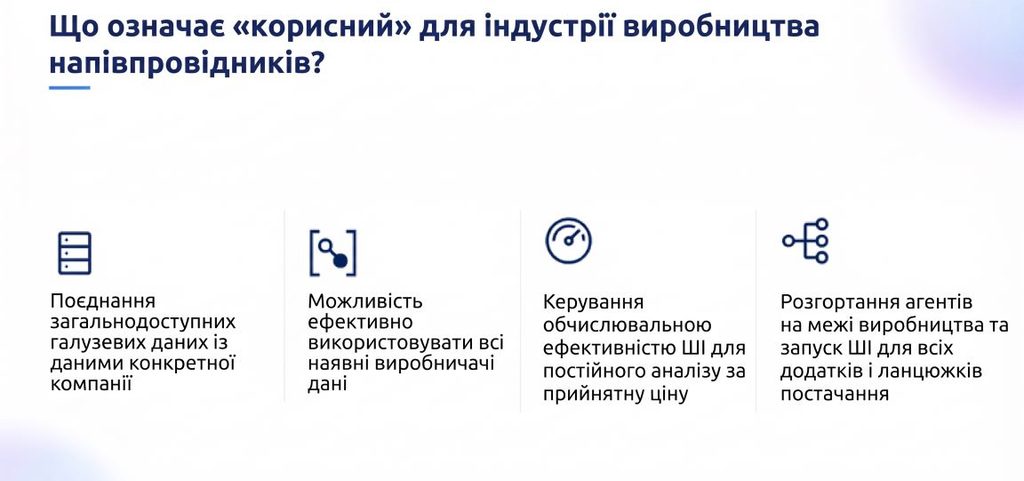
В інтерв’ю The New York Times керівник Nvidia Дженсен Хуанг сказав: «Лише за останні шість місяців, після 15 років спроб, ШІ став корисним». ШІ був корисним і раніше, але ця теза порушує слушне питання для виробництва напівпровідників: що означає «корисний»?
Для виробництва напівпровідників це означає поєднати загальногалузеві дані з даними конкретної компанії; ефективно використовувати всі доступні виробничі дані; контролювати витрати на обчислення для постійного аналізу за допомогою ШІ; розгортати агентів на периферії виробництва — у різних застосунках і ланках постачання.
Усі ці завдання складніші, ніж здається.
Великі мовні моделі вже багато знають про напівпровідники. Запитайте про карти пластин, параметричне тестування, бінування, партії, контрольні карти статистичного контролю процесів, дрейф швидкості травлення чи механізми відмов — і модель міркуватиме досить компетентно. Вона обере методи, згенерує код, інтерпретує результати й підсумує неструктуровані дані. Якщо дати універсальній мовній моделі дані про падіння виходу придатних виробів у партіях і запитати, який аналіз провести, вона запропонує непоганий перший варіант — приблизно те, що запропонував би молодший інженер.
Проблема виникає далі. Менш досвідчений інженер виконує аналіз, бачить сигнал, якого не може пояснити, вважає його шумом і повідомляє, що в даних нічого немає. Старший інженер дивиться на ту саму діаграму й розуміє ситуацію, бо має контекст, якого бракує моделі. Мовні моделі не мають доступу до специфічних для компанії даних та інтелектуальної власності, історичних базових показників, особливостей продукту й процесу — наприклад, рецептів, правил проєктування, тестових послідовностей і визначень бінів. Їм також бракує можливостей масштабних статистичних обчислень і валідації.
Використання всіх доступних даних — окрема проблема. Наші інструменти допомогли розібрати багато випадків різкого падіння виходу придатних виробів, і післяінцидентний аналіз майже завжди показував, що потрібні дані вже були. До події інженер не може знати, які саме з них важливі. Можливість ефективно працювати з широкими наборами даних дає змогу реагувати до того, як станеться збій.
Масштаб приватних даних компаній
Найважливіше для застосування ШІ у виробництві напівпровідників — доступ до складних приватних даних компанії та їх обробка.
Масштаб цих даних значний. Провідні безфабричні компанії та гігантські ливарні виробники зберігають на кожному майданчику петабайти інформації у понад 20 доменах, кожен із яких має щонайменше 100 форматів файлів. Новий 3D-IC на етапі запуску нового продукту може мати 2–10 млн тестових параметрів. Компанії зі змішаними сигналами, які вважають свої тестові програми скромними — близько 10 000 параметрів, — однак накопичують приблизно 200 ТБ аналітичних даних. У всіх цих компаній продуктів більше, ніж працівників, не кажучи вже про інженерів із розроблення продуктів і тестування. На одній ливарній фабриці щотижня аналізують 2–3 трлн параметрів сортування для приблизно 2 000 різних продуктів, причому на кожен виріб припадає понад 100 000 ознак.
Саме тому PDF Solutions створила Exensio Aurora, використавши 30 років знань про виробництво напівпровідників як контекст для ШІ. У нас є петабайти виробничих даних, якими керують в ізольованих хмарних середовищах клієнтів; за останні 15 років для характеристики процесів було виготовлено понад 1 000 тестових чипів. Клієнти на цих майданчиках створили понад 660 000 аналітичних шаблонів і практик. Також у нас є розгорнута онтологія напівпровідникової галузі для збирання й узгодження даних. Дані з різних майданчиків ніколи не об’єднуються, як і агенти, що працюють із ними.
Проблема вартості мовних моделей
Токени стали найбільшою та найшвидше зростаючою статтею витрат на ІТ. Один розробник вичерпав ліміт токенів о 14:00, а роботу, що залишилася на день, вручну довелося б виконувати п’ять годин. Коли ліміт зняли, із токенами завдання зайняло п’ять хвилин. Цей приклад показує і цінність, і вартість обчислень мовних моделей.
Для виробництва проблема полягає у вартості. Виробничий аналіз за своєю природою часто повторюється, але запуск мовної моделі для кожного аналізу теж дорогий, і масштабування не знижує цих витрат. Розгляньмо повторюваний аналіз вибірки зі 100 000 рядків і 10 стовпців:
- Мовна модель щоразу аналізує дані безпосередньо: 30 000 токенів і 30 Вт·год на один аналіз.
- Мовна модель один раз створює аналітичний процес: 20 000 токенів і 20 Вт·год одноразово.
- Збережений процес запускається для кожної нової вибірки: токени не потрібні, витрати енергії — 0,02 Вт·год за запуск.
Повторний запуск процесу, створеного мовною моделлю, потребує приблизно в тисячу разів менше енергії, ніж повний цикл аналізу мовною моделлю. Для повторюваних аналітичних завдань мовні моделі не дають економії від масштабу, а використання їх для кожного аналізу може бути надто дорогим.
Мовні моделі створюють процеси, а процеси виконують роботу
Під час створення Exensio Aurora ми дійшли висновку, що мовним моделям потрібна мова — Python, виражений у вигляді робочих процесів. Такий підхід має чотири складники:
- Узгоджувати й доповнювати дані за допомогою онтології напівпровідникової галузі, щоб модель та інженер однаково розуміли терміни «партія», «пластина», «бін», «тест» та «обладнання».
- Виконувати аналіз на масштабованому обчислювальному рушії, розробленому для напівпровідникових даних, а не витягувати їх через API й доручати обчислення мовній моделі.
- Використовувати мовні моделі для створення робочих процесів та агентів. Модель має не проводити аналіз, а будувати його. По суті, це генерація коду — завдання, у якому мовні моделі найкращі.
- Кодувати контекст і повторюваний аналіз у робочих процесах. Інженер перевіряє результат у вигляді візуальних блоків, а не рядків Python, запускає процес і, якщо він працює, узагальнює його та зберігає в бібліотеці. Наступного разу система виконає збережений процес і не витрачатиме 20 000 токенів.
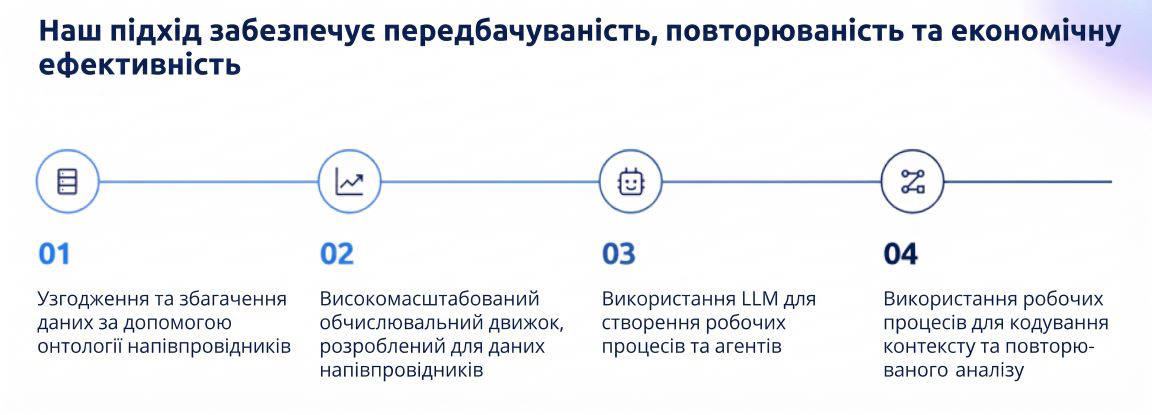
Така архітектура також ізолює дані клієнта від мовної моделі. Клієнти можуть експериментувати з різними моделями, зокрема такими, що не працюють локально, не передаючи їм свої дані. Збережені знання можна повторно перевіряти — це допомагає запобігати галюцинаціям. У результаті аналіз стає передбачуваним, відтворюваним і економічно ефективним. Інженер не може відстежити 10 млн параметрів, але алгоритм може.
Виклик 3. Ефективність ланцюга постачання
Матеріали проходять довгий шлях. У виробництві корпусів із гібридною інтеграцією кожен етап стає частиною складного завдання з координації ланцюга постачання. Виготовлення пластин, підготовка кристалів, з’єднання пластин, стекування кристалів, наскрізні кремнієві перехідні з’єднання та інші міжз’єднання, передове корпусування, тестування й метрологія — це окремі етапи, які виконують різні компанії на різних підприємствах і в різних країнах.
Саме тому PDF Solutions придбала secureWISE — найбільшу захищену мережу, що з’єднує фабрики з постачальниками обладнання. Мережу розгорнуто на фабриках із техпроцесом 3 нм; вона передає екзабайти даних між виробниками обладнання та заводами. Кілька постачальників обладнання створили на її основі власні ШІ-рішення: вони збирають дані з установленого парку обладнання, використовують їх для навчання, а потім надсилають поліпшені алгоритми назад на пристрої.
Ключова відмінність secureWISE — контроль. Трафік шифрується двічі, а вміст пакетів не передається стороннім. Команда фабрики вирішує, які дані й коли залишають підприємство, які дані та алгоритми надходять назад, яку антивірусну перевірку проходить усе, що потрапляє на об’єкт, і зберігає повний журнал усіх цих дій.
Від співпраці людей до взаємодії агентів
Напівпровідникова галузь завжди спиралася на співпрацю, а тепер вона стає агентною. Це підвищує вимоги до тісноти й безпеки зв’язків між учасниками індустрії.
secureWISE створили для співпраці між людьми. На практиці більшість трафіку в мережі й більша частина пов’язаного з ним доходу припадають на дані, що передаються назовні, та програмне забезпечення або алгоритми, які надсилаються назад. Мережа дедалі більше обслуговує агентів і ШІ, а не людей. Ця тенденція посилюватиметься.
Єдина платформа для проєктування, виробництва й ланцюга постачання
Тиск щодо підвищення ефективності не зникне. Датацентрам потрібно більше обчислень на мегават, виробникам — більше корисних висновків на токен і ядро, а ланцюгам постачання — дедалі частіше й безпечніше передавати дані та алгоритми між агентами, як раніше передавали їх між людьми.
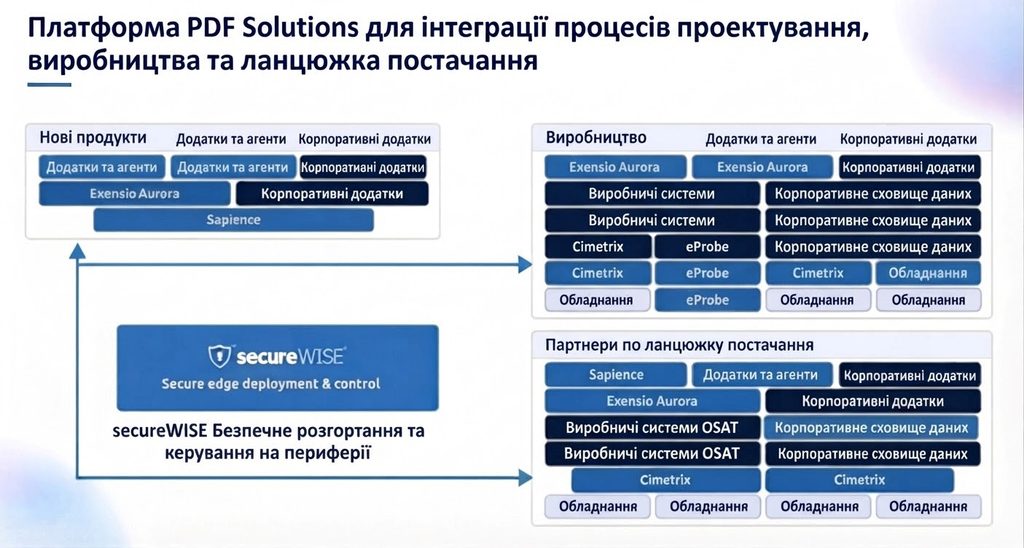
Наша архітектура об’єднує енергоефективність, ефективне використання даних і обчислень та ефективність ланцюга постачання в одній платформі. Такий самий стек застосовується під час розроблення нових продуктів, у виробництві та на майданчиках партнерів ланцюга постачання, зокрема OSAT-компаній. Exensio Aurora й корпоративні застосунки працюють на Sapience, а над ними розміщуються застосунки й агенти. На фабриках і підприємствах OSAT компанія Cimetrix з’єднує обладнання, зокрема eProbe, із виробничими системами та корпоративними сховищами даних. secureWISE забезпечує захищене розгортання й контроль на периферії. Це дає змогу передавати між майданчиками дані, правила, робочі процеси й агентів під контролем їхніх власників.
Нагадаємо, у добірці зібрано інструменти ШІ для автоматизації, аналітики та створення контенту, які можуть допомогти стартапам оптимізувати процеси й прискорити зростання.
 Miltech