
25.09.2026 10:13
ШІ може встановлювати особи за анонімними дописами: що показало дослідження
Користувачі соцмереж заговорили про кінець анонімності в інтернеті після того, як дослідження про можливості ШІ знову поширилося на X і Reddit. У ньому йдеться про те, що мовні моделі можуть зіставляти анонімні дописи з реальною особою.
Статтю «Масштабна деанонімізація в інтернеті за допомогою великих мовних моделей» підготували дослідники ETH Zurich і групи з безпеки ШІ MATS разом із Ніколасом Карліні, дослідником Anthropic — компанії, що розробила Claude.
Автори стверджують, що великі мовні моделі, на яких працюють Claude, ChatGPT і Gemini, здатні прочитати анонімні дописи й визначити, хто їх написав. Для цього не потрібно нічого зламувати: достатньо читати, шукати й аналізувати інформацію — тобто виконувати завдання, з якими чатботи вже справляються щодня.
Дослідження привернуло увагу після допису на X, де стверджувалося, що ШІ може деанонімізувати акаунт Reddit менш ніж за хвилину й приблизно за $2. Автор допису назвав це доказом того, що практична анонімність в інтернеті зникла. У дописі також є зображення.
«Наші результати показують, що практична непримітність, яка захищала псевдонімних користувачів в інтернеті, більше не працює, а підходи до оцінювання загроз для онлайн-приватності потрібно переглянути», — йдеться у статті.
Як працює система
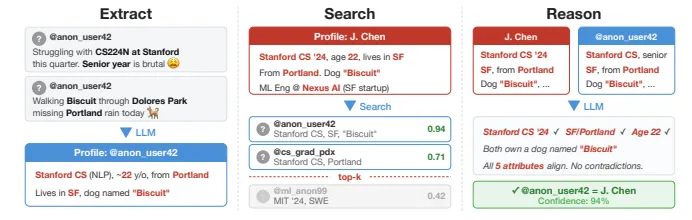
Дослідники поділили процес на чотири етапи: вилучення даних, пошук, аналіз і калібрування.
На етапі вилучення ШІ аналізує дописи й складає узагальнений опис людини: де вона може жити, ким працює, чим цікавиться. До опису можуть потрапити й дрібні деталі — наприклад, британський правопис або ім’я собаки, згадане мимохідь.
Під час пошуку цей опис перетворюється на векторне подання — послідовність чисел, за якою комп’ютер може швидко знаходити схожі профілі серед тисяч кандидатів.
Далі потужніша модель аналізує кілька найкращих збігів і перевіряє, який із них відповідає опису. Автори порівнюють це з роботою людини-розслідувача, але ШІ виконує її швидше.
На етапі калібрування модель оцінює власну впевненість: робить припущення, лише якщо вважає його достатньо надійним, інакше утримується від відповіді.
В одному з тестів команда зібрала 338 користувачів форуму Hacker News, які переважно пишуть під псевдонімами, але додали у свої профілі посилання на LinkedIn. Дослідники прибрали ідентифікаційні дані й попросили агента ШІ визначити особи користувачів, використовуючи лише вебпошук. Система правильно назвала 226 людей — 67% вибірки. Приблизно одна з десяти зроблених нею спроб виявилася хибною.
В іншому тесті ШІ аналізував стенограми інтерв’ю Anthropic зі 125 науковцями. За описами їхньої роботи система змогла правильно визначити щонайменше дев’ятьох людей.
Чому результати викликають занепокоєння
Одна з головних знахідок дослідження — низька вартість такого аналізу. За підрахунками авторів, перевірка одного користувача коштує від $1 до $4 у вигляді плати за ШІ-сервіси.
Для цього не потрібні витік даних, злам чи доступ зсередини. Система використовує вебпошук і узагальнення інформації — функції, які є у звичайних чатботах. На думку дослідників, саме це ускладнює протидію: немає окремої команди «деанонімізуй цю людину», натомість процес складається з низки завдань, кожне з яких окремо виглядає нешкідливим.
Це не перший випадок, коли за набором деталей вдається встановити особу. У 2008 році дослідники деанонімізували дані Netflix про перегляди, зіставивши нібито анонімні оцінки фільмів із відкритими відгуками на IMDb. Різниця тепер у тому, що ШІ може самостійно зіставляти неструктурований текст — жарти, коментарі й побіжні згадки, а не лише дані в таблицях.
Що варто врахувати
Найбільш тривожні цифри в статті мають важливе обмеження. Щоб оцінити точність, дослідникам потрібно було знати справжні особи учасників. Тому вони обрали акаунти, уже пов’язані з LinkedIn, або розділили історію дописів однієї людини на дві частини й приховали зв’язок між ними.
Це контрольований сценарій із сприятливими для дослідників умовами, а не доказ того, що сьогодні можна деанонімізувати будь-який випадковий псевдонімний акаунт.
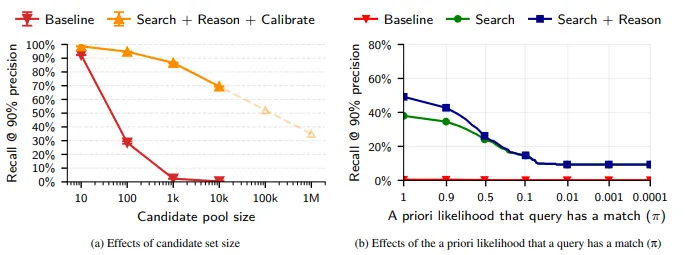
На результати впливає і розмір пошукової вибірки: що більше можливих кандидатів, то складніше знайти потрібну людину. Серед 89 000 профілів найефективніший метод ШІ правильно знаходив приблизно половину збігів за точності 90%. Точність показує, як часто система має рацію у своїх припущеннях, а повнота — скільки реальних збігів їй вдалося виявити.
Дослідники не оприлюднили інструменти, промпти чи справжні імена людей, яких змогли встановити. Перед публікацією роботу перевірила етична комісія. Автори не передають читачам інструкцію для доксингу, а описують можливість, яка, за їхніми словами, вже є в сучасних моделях ШІ незалежно від появи статті.
Чому це стосується не лише користувачів Reddit
Користувачам криптовалют ця загроза знайома. Після витоку даних Coinbase у 2025 році та інших подібних випадків відбулися доксинг і спроби викрадень. Ці події показали, як швидко викрита особа може перетворитися на адресу біля чиїхось дверей.
Деанонімізація за допомогою ШІ створює подібний ризик, але без витоку: система працює з інформацією, яку людина вже опублікувала у відкритому доступі.
За кілька місяців до цього Anthropic повідомила, що пов’язані з державою хакери використали Claude для самостійного виконання більшої частини кампанії кібер espionажу. Цей випадок також свідчить, що дослідження зловживань ШІ випереджають засоби захисту, покликані їх стримувати.
Для людей, які пишуть під псевдонімом через активізм, пережите насильство, сексуальність, імміграційний статус або роботу, де не схвалюють публічні висловлювання, важливими можуть стати навіть дрібниці. Місто, роботодавець чи ім’я домашньої тварини, розкидані в старих коментарях за кілька років, разом утворюють своєрідний цифровий відбиток. Така можливість існувала й раніше, але ШІ робить пошук швидшим і дешевшим.
Якщо доксинг викликає занепокоєння, відповіддю має бути не паніка, а обережніша поведінка: не пов’язувати з одним псевдонімом надто багато конкретних ідентифікаційних деталей, а для справді чутливої інформації використовувати інструменти, які не зберігають дані.
У матеріалі про великі мовні моделі пояснено, як трансформерна архітектура та механізми уваги допомагають обробляти послідовності й генерувати текст.
)
)
)
)
)
)
)
)
