
 Техно
Як наблизити обчислення до пам’яті для ШІ-інференсу
Перенесення обчислень ближче до пам’яті може зменшити енергоспоживання й затримки та підвищити продуктивність. Однак для ширшого впровадження таких рішень потрібні відповідне програмне забезпечення, стандарти й ефективне керування теплом.
Перехід від навчання моделей ШІ у датацентрах до інференсу на периферії потребує переосмислити, де й як обробляють і зберігають дані, як визначають їхню важливість і чим доводиться поступатися в продуктивності чи енергоспоживанні, щоб залишитися в межах обмеженого енергетичного бюджету.
Центральна ідея — обробляти якомога більше даних біля пам’яті. Це особливо актуально для фізичного ШІ, де сенсори передають дані в реальному часі. Такий підхід обговорюють ще від початку розвитку Інтернету речей, але поширення ШІ та величезні потоки даних загострили питання енергії, потрібної для їх переміщення й обробки. У електромобілях і дронах менші витрати енергії на обробку даних означають більший запас ходу на одному заряді й більше енергії для критичних та другорядних функцій.
Системі потрібно визначати, які дані зберігати, які відкидати, а на які реагувати. Для цього потрібна складна обробка, а найшвидший і найменш енерговитратний шлях до результату — скоротити відстань, яку дані проходять між пам’яттю та обчислювальним блоком.
«Поява великих мовних моделей у фізичних пристроях змушує всіх переосмислювати архітектуру пам’яті. Навіть якщо не говорити про обчислення в пам’яті, а взяти звичайну пам’ять: як розподілити моделі, щоб максимально підвищити продуктивність процесора загалом і підсистеми пам’яті?», — сказав Френк Ферро, директор із продуктового менеджменту Cadence.
Для цього потрібні нові підходи, зокрема обчислення поблизу пам’яті (PNM) та обчислення в пам’яті (PIM), а також удосконалення різних технологій. Компілятори й операційні системи мають адаптуватися, а для галузі потрібні стандарти.
«Останні кілька років увага всіх була зосереджена на ШІ в датацентрах і великих мовних моделях. Тепер моделі навчили й почали розгортати на периферії мережі та у фізичних системах. Але обчислювальні ресурси й обсяг пам’яті там обмежені», — сказав Ферро.
Інференс на периферії має інші особливості, ніж навчання моделей у датацентрах. Під час навчання доступ до пам’яті зазвичай змінюється, а код часто виконується інтерпретатором — наприклад, Python у PyTorch. Це ускладнює узгодження даних між рівнями пам’яті.
«Коли починається інференс, модель використання змінюється докорінно. Незалежно від того, чи йдеться про великі моделі в датацентрі, чи про локальні менші мовні моделі або моделі “бачення — мова — дія” в автомобілях, модель відома до запуску, а отже, наперед відомі й шаблони доступу до даних. Саме тут компіляція заздалегідь може ефективно використовувати різні варіанти обчислень біля пам’яті, у пам’яті або безпосередньо в ній. Система заздалегідь знає, де, коли й як відбуватимуться обчислення. Їй не потрібно вгадувати, чи змінював хтось дані в іншій підсистемі пам’яті: взаємодію компонентів планують за години, дні або тижні до виконання, коли компілюють модель інференсу», — сказав Стів Родді, директор із маркетингу Quadric.
Не всі етапи інференсу однаково виграють від рішень із наближенням обчислень до пам’яті.
«Перенесення обчислень у DRAM або ближче до неї має цікаві наслідки. Змінюється схема обміну даними: активації надходять до пам’яті замість того, щоб пам’ять надсилала дані до активацій. Це змінює потрібний обсяг передавання. Такі рішення підходять для декодування з малим розміром пакета, наприклад коли пакет містить один елемент і не потрібно зчитувати всі ваги. Але за декодування великими пакетами, оптимізованого за вартістю, або під час попереднього заповнення контексту, де виконуються великі пакети, складним стає передавання активацій. Виконання потрібно розподіляти на частини залежно від того, чи чутливі вони до обсягу даних, пропускної здатності або розміру пакета», — сказав Шарад Чоле, головний науковець і співзасновник Expedera.
Наближення обчислень до даних скорочує час і енергію на їх переміщення. Виконання операцій у тому самому корпусі пам’яті, як-от у спеціальній HBM, або на тому самому кристалі пам’яті, як у LPDDR6-PIM, дає дві основні переваги.
«Перша — продуктивність. Якщо процесор або його ядро в SoC щоразу звертається до пам’яті по дані, запит проходить через кеш у SoC, а потім дані повертаються до процесора. Це потребує часу», — сказав Кос Гічев, директор із маркетингу продуктів Cadence.
Архітектори можуть швидко виконувати обчислення в SoC, але сам чип мусить чекати на дані. «Обчислення в пам’яті значною мірою розв’язують цю проблему. Можна вказати: “Візьми цей фрагмент даних у пам’яті й опрацюй його”, а потім просто зчитати результат. Так ми пропускаємо весь етап зчитування даних, окремого обчислення й запису результату назад», — сказав Гічев.
Де саме відбуваються обчислення
- CIM (compute-in-memory) / IMC (in-memory computing), апаратне забезпечення: обчислення виконує сам масив пам’яті — усередині бітових комірок і ліній бітів. Обробка часто аналогова: струми або заряди сумуються на лініях бітів, але існують і цифрові варіанти. Приклад — аналогова операція множення з накопиченням на лініях бітів SRAM або ReRAM.
- IMC (in-memory computing), корпоративне програмне забезпечення: бази даних або аналітика працюють із даними в RAM, а не на диску. Обчислення виконують звичайні процесори; дані мають цифрову форму. Приклад — SAP HANA. Це не значення терміна, яке використано в цій статті.
- PIM (processing-in-memory), апаратне забезпечення: логіку розміщено на тому самому кристалі DRAM, що й звичайний масив пам’яті. Цифрова логіка розташована поруч із банками пам’яті, а дані зчитуються з масиву. Приклад — LPDDR6-PIM, стандарт JEDEC для якого наближається до завершення.
- PNM (processing-near-memory), апаратне забезпечення: логіку розміщено в корпусі пам’яті, але на окремому кристалі. Цифрова логіка міститься на базовому кристалі, а дані зчитуються з масиву. Приклад — обчислення на базових кристалах спеціальних HBM4/HBM4E, передбачені дорожньою картою.
У апаратній сфері CIM та IMC вживають як взаємозамінні назви архітектур, що виконують обчислення безпосередньо в масиві пам’яті. Водночас IMC має й окреме значення у корпоративному програмному забезпеченні. Джерело: Semiconductor Engineering.
Менше переміщення даних
Щоб цей підхід запрацював, потрібно оптимізувати всю систему.
«Фокус змістився від “нам потрібно більше пам’яті” до “нам потрібна мережа міжз’єднань, яка забезпечить пам’ять даними й не завадить іншому трафіку”. А останнім часом питання звучить так: як проєктувати системи в умовах дефіциту?», — сказав Нандан Наямпаллі, комерційний директор Baya Systems.
«Можливості систем ШІ дедалі більше обмежує ефективність передавання даних між обчислювальними блоками, пам’яттю, прискорювачами, чиплетами й кристалами. Тому міжз’єднання й архітектура пам’яті не менш важливі, ніж сам пристрій пам’яті. Для оптимізації переміщення даних ще до виготовлення чипа потрібні масштабовані технології NoC, чиплетів, когерентності кешу та системного відображення», — сказав Енді Найтінгейл, віцепрезидент із продуктового менеджменту та маркетингу Arteris.
На периферії зростає роль міжз’єднань, кешування й корпусування. Водночас складно підібрати їхню комбінацію та втримати витрати. Нові покоління пам’яті з високою пропускною здатністю дають змогу розміщувати більше обчислень на базовому кристалі багатокристального стека. Але залежно від вартості привабливішим може виявитися LPDDR6-PIM, де обчислювальні блоки розташовано поруч із банками DRAM.
«Обчислення поблизу пам’яті досі використовують зовнішній канал зв’язку. Але розміщення обчислювальних блоків біля даних пам’яті дає змогу прибрати значну частину передавання даних і підвищити енергоефективність. Також можна перенести обчислення з CPU або GPU, краще використовуючи ці процесори», — сказав Хошик Кім, старший віцепрезидент і науковий співробітник SK hynix.
Типові сценарії передбачають розміщення контролерів пам’яті на базовому кристалі.
«Ми інтегруємо корисні блоки обчислень поблизу пам’яті, щоб знімати з процесора прості операції множення з накопиченням. У задачах інференсу більшість обчислень — це прості операції MAC. Їх можна виконувати на базовому кристалі, а складніші й більш обчислювально інтенсивні завдання залишити GPU», — сказав Кім.
Розробка триватиме роками
Деякі потрібні технології вже доступні, іншим знадобляться роки розробки або вдосконалення, перш ніж вони дадуть відчутний результат.
«Ми очікуємо на застосування обчислень у пам’яті через три-п’ять років, можливо, близько 2030 року. Потрібно з’єднувати багато GPU, щоб вони могли звертатися до пам’яті одне одного. Компанії намагаються збільшити обсяг пам’яті на GPU, але є обмеження, пов’язані з розміром пакетів, пропускною здатністю HBM тощо. Обчислення в пам’яті — один зі шляхів: базовий кристал пам’яті отримує певні обчислювальні можливості», — сказав Вішал Чандрасекар, директор із продуктового менеджменту Ayar Labs.
Однак до комерціалізації технологія ще не готова.
«Було б перебільшенням сказати, що ми вже бачимо її на ринку. Можливо, у деяких вузькоспеціалізованих вбудованих системах використовують певний різновид обчислень у пам’яті, але широке застосування поки що на ранньому етапі», — сказав Ферро з Cadence.
Рішення PIM поступово переходять від досліджень до комерційного застосування. Наприклад, Samsung оголосила про архітектуру та показники продуктивності свого чипа LPDDR6-PIM, призначеного для малопотужних мобільних пристроїв із ШІ на борту.
«LPDDR-PIM привернула найбільшу увагу в JEDEC. Її активно розробляють і обговорюють, але є проблеми і з апаратною, і з програмною частиною. З апаратного боку поєднуються логічний і DRAM-процеси, оптимізовані за різними параметрами. Це ускладнює та здорожчує виробництво. Потрібно ретельно перевірити, чи виправдовує конкретне застосування додаткові витрати», — Ренді Вайт, менеджер програм рішень для пам’яті в Keysight.
LPDDR6-PIM може використовуватися у стаціонарних периферійних серверах, де важлива продуктивність, а також у телефонах і планшетах, оптимізованих для енергоефективності.
Програмні труднощі можуть бути складнішими за апаратні
«Як керувати нерівномірним навантаженням і балансувати його? Уявімо масив пам’яті або обчислювальне ядро, поділене на комірки, де через кожні десять колонок пам’яті розміщено вертикальний сегмент логіки. Під мікроскопом такий PIM-кристал нагадував би шахівницю з повторюваними сегментами. Це створює обмеження за часом: під час доступу до рядка потрібно дочекатися завершення обчислення за інструкцією в обчислювальному блоці. Отже, недостатньо просто отримати дані й узгодити час доступу до різних банків. Тепер доступ до пам’яті пов’язаний із очікуванням результату обчислення. Мета — менше переміщувати дані, обмінюючись ними між сусідніми комірками, і це знижує енергоспоживання. Але для інженера, який пише BIOS і створює планувальник синхронізації, складність різко зростає», — сказав Вайт.
Потрібно також враховувати вплив архітектур PIM на решту системи.
«Апаратну частину треба спроєктувати й оптимізувати так, щоб кількість обчислювальних коефіцієнтів та інших параметрів була правильною. Пам’ять треба розділяти так, щоб не отримати надто дрібну деталізацію, і знайти правильний баланс між грубим та точним поділом», — сказав Вайт.
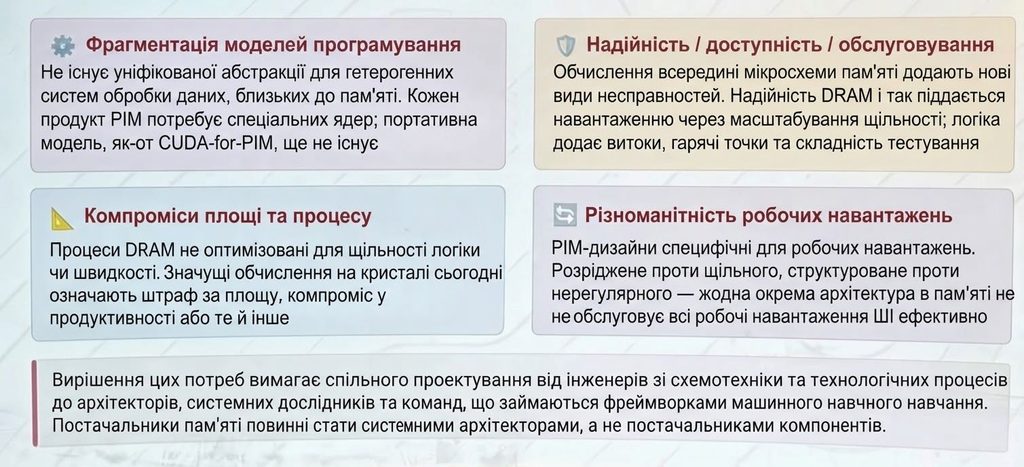
Моделі програмування пам’яті досі змінюються, особливо через поширення нетрадиційних систем: PIM, CIM, багаторівневої пам’яті з підключенням через CXL і гетерогенних архітектур.
«Не думаю, що галузь зупиниться на одній моделі програмування та одній реалізації когерентності. За останні 40 років створили різні моделі програмування, протоколи когерентності й моделі узгодженості, що дають розробникам систем і застосунків різні компроміси. Різноманіття архітектур і реалізацій когерентності збільшує потребу у високопродуктивних бібліотеках зі спільними функціями, оптимізованими для різних систем. Такі бібліотеки забезпечують абстракцію, яка підвищує переносність програм і масштабованість продуктивності, не змушуючи програмістів розбиратися в усіх деталях апаратної платформи», — сказав Стівен Ву, науковий співробітник і почесний винахідник Rambus.
Компілятори й контролери пам’яті
Для підтримки нових архітектур пам’яті потрібні програмні інновації.
«Питання вже не в тому, чи життєздатна PIM і чи має вона сенс Це вже реальність. Проблема в тому, як створити програмну інфраструктуру для компілятора й системне програмне забезпечення. До цього має долучитися вся екосистема», — сказав Кім із SK hynix.
«Системи нині побудовані так, що компілятори, операційні системи й решта програм працюють із процесорним ядром або прискорювачем у SoC, а вся інфраструктура розрахована на те, що роботу виконує цей процесор. Тепер частину завдань можна передати пам’яті: не обов’язково залучати процесор до кожної операції. Але для цього потрібна інфраструктура. Операційна система й процесор мають розуміти, які операції можна доручити пам’яті, а для яких вона не підходить або система виконає їх ефективніше локально», — погодився Гічев із Cadence.
Потрібна також стандартизація взаємодії компонентів усередині чипа.
«Нині немає належного способу наказати пам’яті виконати певну операцію — на рівні транзакцій між процесором, мережевою структурою SoC і пам’яттю. Потрібні апаратні засоби й протокол, які передаватимуть пам’яті команду, а також програмне забезпечення й операційна система, що підтримуватимуть таку роботу та визначатимуть її ефективність», — сказав Гічев.
За словами Ферро, йдеться про два потоки даних: один відповідає за зберігання, читання й запис, другий — за обчислення.
«Це не відповідає звичній будові операційних систем і процесорів. Потрібна взаємодія виробників процесорів, інтерфейсу між процесором і мережевою структурою, самої системи та операційної системи. Усі ці компоненти доведеться адаптувати. Масштаб змін може бути різним, але без стандартів кожну систему доведеться суттєво налаштовувати окремо», — сказав Ферро.
Домашні агенти й контролери пам’яті
Архітектури обчислень поблизу пам’яті та в пам’яті створюють нові вимоги до керування трафіком і когерентності системи.
«У традиційних системах із апаратною когерентністю домашні агенти відстежують, де в системі використовують спільні дані, і забезпечують обчислювальні елементи коректними копіями. Апаратна когерентність звільняє програмістів від потреби вручну оновлювати дані між обчислювальними елементами. Примітиви синхронізації, як-от блокування й бар’єри, а також програмна когерентність дають застосункам додатковий контроль над тим, як і коли оновлювати дані. Разом ці апаратні та програмні механізми дають змогу створювати ефективні алгоритми й приховувати деталі обладнання, спрощуючи програмування та керування узгодженістю даних», — пояснив Ву з Rambus.
Через це програмним інженерам дедалі частіше потрібно розуміти апаратну частину — і навпаки.
«Зі збільшенням задач і кількості обчислювальних елементів досягати доброї масштабованої продуктивності стає складніше. Домашні агенти звільняють програмістів від керування когерентністю, але повідомлення, якими вони її підтримують, можуть стати вузьким місцем. Щоб отримати добру продуктивність, програмістам доводиться дедалі краще розуміти структуру й функції обладнання. Алгоритми часто змінюють, щоб розподілити дані між незалежними завданнями та зменшити трафік когерентності. У деяких системах найкращу продуктивність дає відмова від апаратної когерентності, але програмувати такі системи складніше», — сказав Ву.
Перед контролером пам’яті стоять два завдання.
«Підсистема пам’яті складається з фізичного інтерфейсу (PHY) і контролера. Саме контролер виконує команди. Раніше основними командами були читання й запис даних. Тепер потрібні інші: наприклад, узяти дані, перемножити їх або виконати іншу операцію. Для контролера це не надто складно: можна додати команди й оптимізувати їх виконання», — сказав Гічев.
Друге завдання складніше: процесор має вміти надсилати ці команди.
«Він повинен підготувати пам’ять у підсистемі так, щоб потрібні дані й результат опинилися у правильних місцях, а система знала, коли операцію завершено. Частину цього бере на себе контролер, але йому потрібна тісна взаємодія з усією системою», — сказав Гічев.
Тепло, фізичні обмеження та CIM
Обчислення поблизу пам’яті можуть зменшити трафік даних, але водночас загострити фізичні проблеми, зокрема теплові.
«Дефіцит пам’яті частково спричинений тим, як нині проєктують і використовують доступну пам’ять. Нові конструкції можуть зменшити потребу на одиницю продуктивності й поліпшити використання ресурсів. Найперспективніші способи підвищити ефективність пам’яті — вищі стеки HBM, спеціальна HBM, обчислення поблизу пам’яті та в пам’яті, а також розподіл системи на чиплети — мають спільну рису: вони замінюють проблему пропускної здатності проблемою фізики. Розміщення пам’яті ближче до обчислень концентрує тепло саме там, звідки його найважче відводити. Різнорідні стеки матеріалів і мікронні міжз’єднання створюють термомеханічні напруження й деформації, що не зупиняються на межі кристала, корпусу чи плати. Тепло не зупиняється на чипі — як і пов’язані з ним обмеження», — сказав Сатіш Радгакрішнан, керівник глобального напряму прикладних рішень Vinci.
Тому виробники пам’яті часто анонсують нові теплові технології разом із новими архітектурами. SK hynix представила рішення інтегрованої HBM (iHBM), у корпус якої вбудовано елементи охолодження. У нещодавній дорожній карті Micron згадала вертикальну HBM (vHBM) із термічно адаптованою конструкцією та теплорозподільником над PHY. Samsung працює над відведенням тепла за допомогою гібридного з’єднання міддю (HCB) і блоку теплового каналу (HPB), який планує включити до HBM5.
Кім із SK hynix запропонував використовувати обчислення в пам’яті, щоб зменшити нагрівання базового кристала HBM.
«DRAM дуже чутлива до температури, коли її розміщено над логікою. Логіка схильна до локальних перегрівів, які виникають біля нижньої частини пам’яті. Це серйозна теплова проблема, яку потрібно розв’язати. Обчислення в пам’яті можуть стати одним із рішень. Вони споживають дуже мало енергії, тож їх можна розмістити на базовому кристалі або внизу пам’яті», — сказав він.
На практиці IMC/CIM може працювати зі спеціальною HBM4 або HBM4E, адже базовий кристал виготовляють за логічним процесом ливарного виробництва. SRAM є природним для нього типом пам’яті, тому на цьому кристалі можна створювати макроси SRAM CIM. CIM виконує множення з накопиченням усередині масиву SRAM, тож ваги не потрібно постійно переміщувати між пам’яттю та окремим MAC-блоком. Основна частина енергії витрачається саме на переміщення даних, тому для макросів SRAM CIM заявляють значно вищу енергоефективність — кількість операцій на ват — порівняно зі звичайними цифровими прискорювачами. Менше енергії на операцію означає нижчу щільність потужності й менше локальних перегрівів під DRAM.
Висновки
Програмна підтримка залишається відсутньою ланкою між апаратними рішеннями з наближенням обчислень до пам’яті та їхнім потенціалом для ШІ. Для компіляторів і фреймворків ШІ архітектури PNM та обчислень у пам’яті стають новими цілями: вони можуть дати змогу передавати математичні операції безпосередньо підсистемі пам’яті. Програмне забезпечення для такого переходу ще розвивається.
Доступні обчислювальні можливості й обмеження залежать від архітектури. LPDDR6-PIM обмежена блоками MAC або простими ALU, придатними для множення матриці на вектор і поелементних обчислень. Базовий кристал спеціальної HBM4/HBM4E, виготовлений за логічним процесом, може виконувати й інші функції керування пам’яттю. Але цьому заважають теплові обмеження: кількість обчислень визначається тим, скільки тепла вони додають під DRAM.
«Останні два роки ми багато говорили про спеціальну HBM і про те, як використовувати її базовий шар», — зазначив Ферро з Cadence.
ШІ стимулює перенесення обчислень ближче до пам’яті, але самої близькості недостатньо. Ширше впровадження залежить від того, чи відповідатиме обладнання конкретним завданням, чи вдасться керувати теплом і чи отримають компілятори та операційні системи інструменти для вибору операцій, які варто передавати пам’яті. Перемістити обчислення — лише частина рішення; наступне завдання — забезпечити ефективне використання системи.
Джерела
- Спеціальна дослідницька сесія DAC 2026: «Near-Memory Processing is Becoming a Reality» (SK hynix).
- «Cooling design emerges as battleground for next-gen AI memory» (Korea Times).
Нагадаємо, моделі з відкритими вагами можна запускати локально, що потенційно розширює доступ до ШІ та підтримує незалежні дослідження. Водночас їх поширення порушує питання контролю, вартості й доступу до розвитку технологій.
 Штучний Інтелект
 Ad Lucem