 Штучний Інтелект
У реальному тесті майже три чверті завдань від ШІ-агентів потребували ручного доопрацювання
Дослідники Alibaba та кількох азійських університетів створили бенчмарк для агентів кодування на основі реальних запитів користувачів. Навіть найкраща модель повністю виконує лише приблизно одне завдання з чотирьох — на тлі майже бездоганних результатів у старіших тестах це показує, наскільки ті могли бути простими.
Команда розробила Co-Design Bench — тест, у якому агенти мають змінювати вже наявні вебзастосунки за запитами користувачів. Як вхідні дані вони можуть отримувати зображення, аудіозаписи, відео або документи.
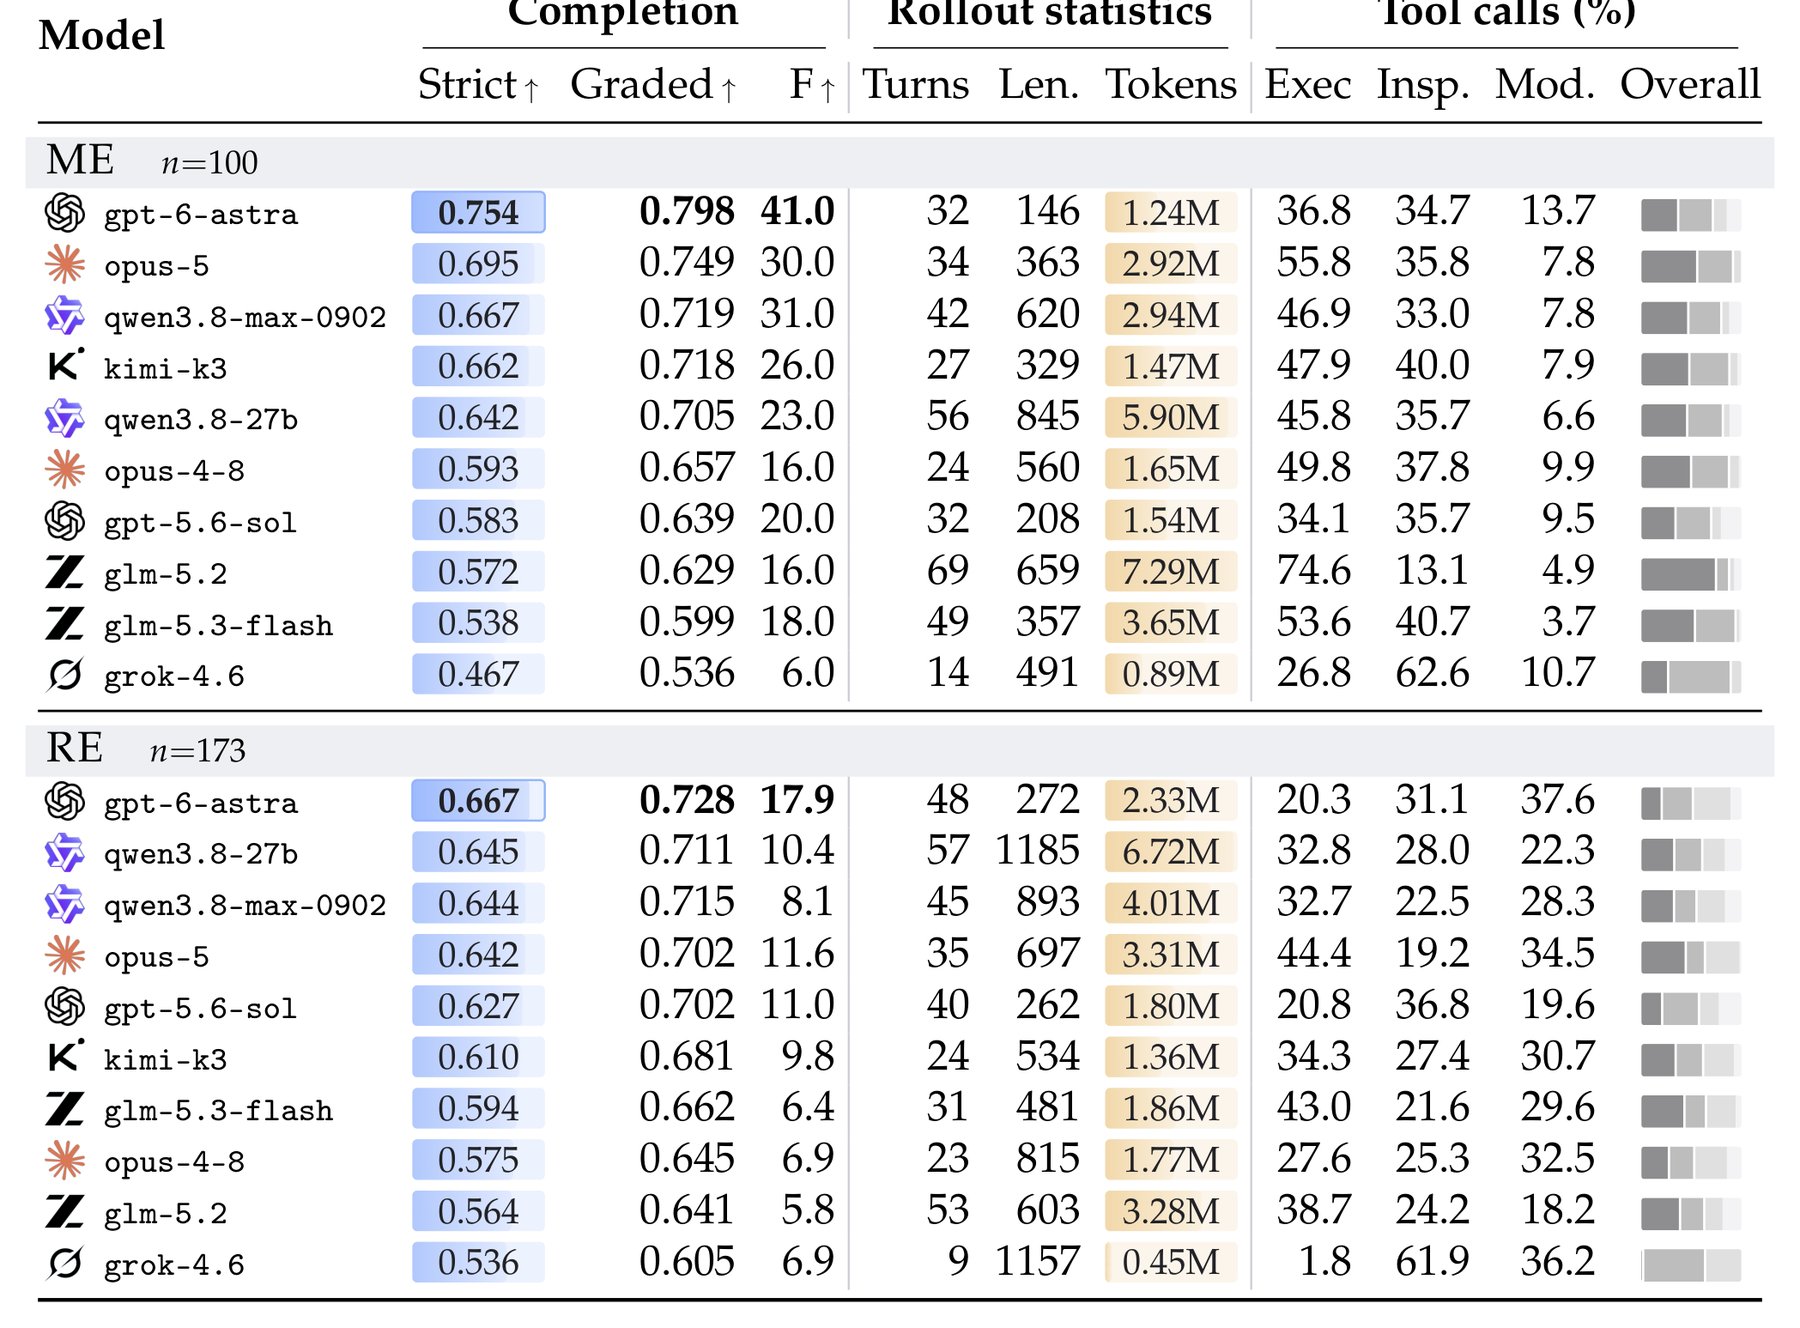
За даними дослідження, GPT-6 Astra — найкраща з десяти перевірених моделей — у середньому виконує близько 70% вимог завдання. Однак повністю правильний результат вона дає лише у 26,4% випадків. Зазвичай агент робить більшу частину роботи, але залишає незавершеною принаймні одну деталь, тож результат майже завжди доводиться допрацьовувати вручну.
Наявні бенчмарки стали надто простими для агентів
Автори пояснюють потребу в новому тесті тим, що наявні бенчмарки вже не дають змоги добре розрізняти моделі. Коли моделі можуть самостійно запускати, перевіряти й виправляти код, їхні результати в таких тестах перевищують 99%, а відмінності між ними майже непомітні.
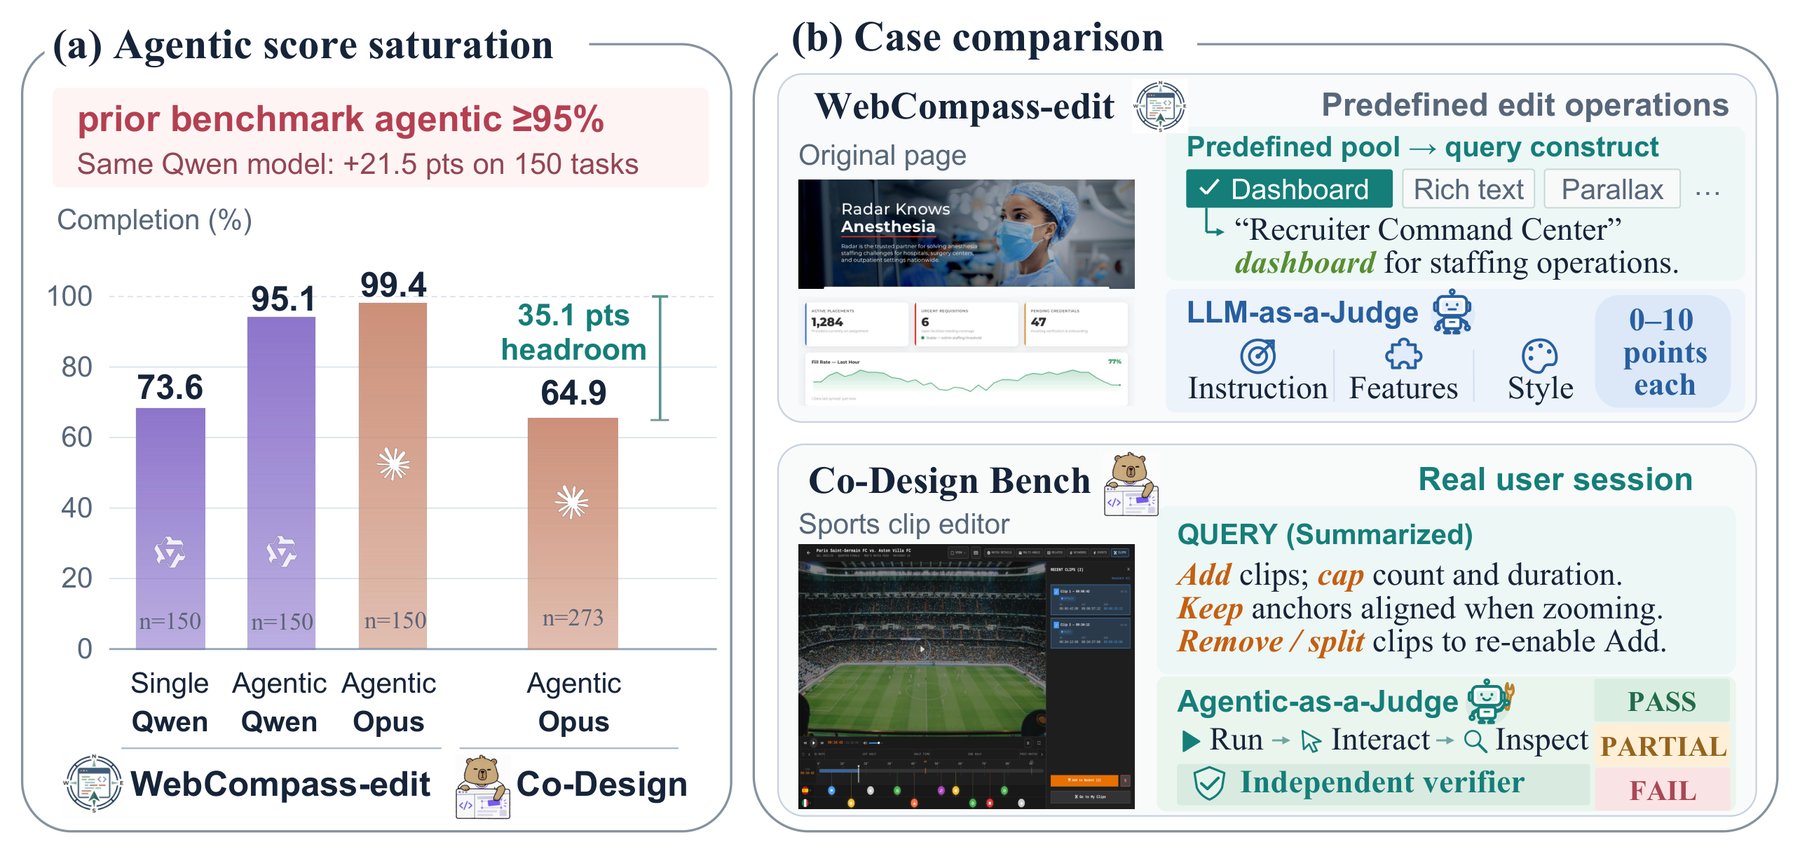
На відміну від старих тестів, Co-Design Bench спирається на запити з реальних сесій роботи з кодом. Дослідники відібрали випадки, у яких користувачам доводилося кілька разів переформульовувати запит або скасовувати зміни. Тому до бенчмарку переважно увійшли завдання, які вже створювали труднощі для агентів на практиці: від невеликих правок — наприклад, знайти суму в чеку й оновити всі залежні підсумки — до масштабної переробки проєктів.
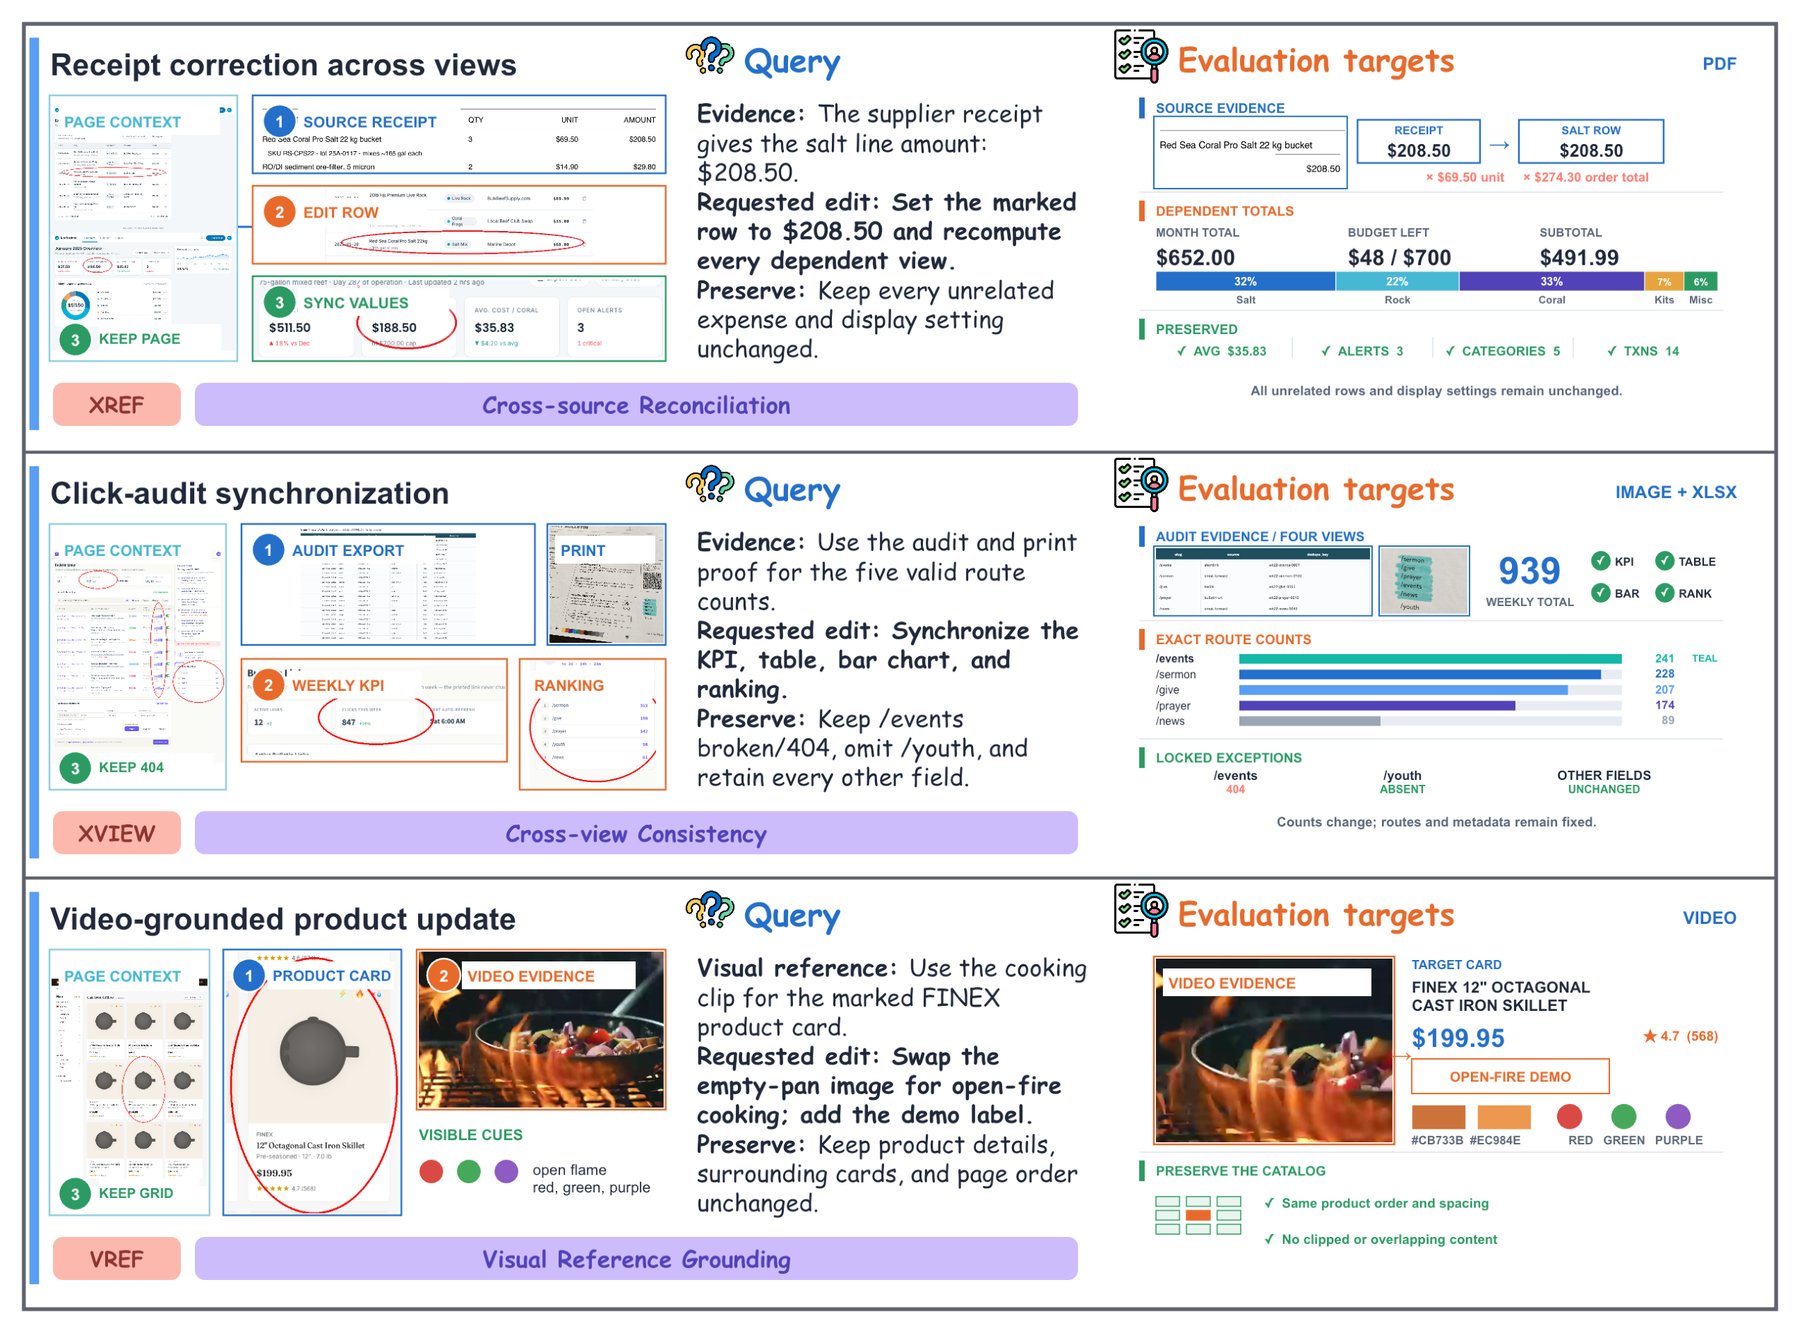
Оцінювання також суворе. Один ШІ-оцінювач перевіряє готовий застосунок у браузері, а другий повторно аналізує кожен позитивний вердикт і шукає макети або результати, зашиті в коді. Бали нараховують лише за функції, які справді працюють у застосунку.
Поєднання різних типів змін ускладнює завдання
Після GPT-6 Astra у рейтингу йдуть Claude Opus 5 і Qwen3.8-Max, а останнє місце посідає Grok 4.6. У масштабних переробках друга позиція дісталася значно меншій моделі Qwen3.8-27B, але автори не вважають цей результат доказом її загальної переваги.
Результати всіх моделей погіршуються, коли завдання поєднує кілька видів змін: у макеті, дизайні, взаємодії та вмісті. У реальних проєктах такі вимоги зазвичай переплетені.
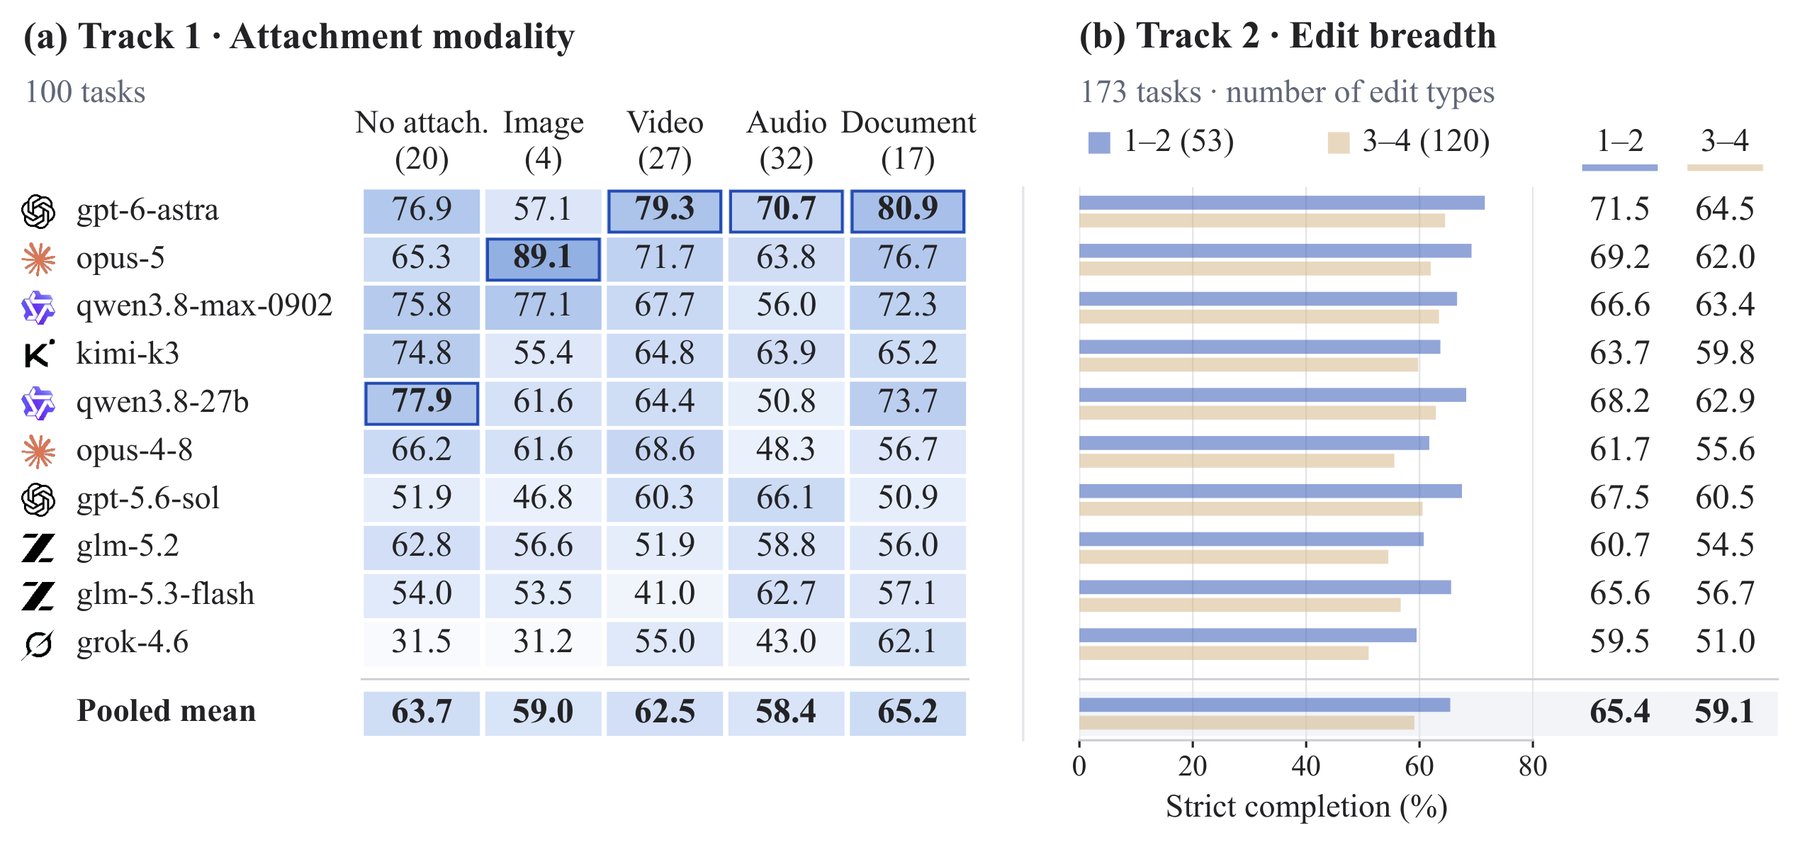
Збільшення обчислень майже не усуває цю слабкість. На невеликих змінах GLM-5.2 витрачає майже вшестеро більше токенів, ніж GPT-6 Astra, але все одно показує значно гірший результат.
На результати впливає не лише модель, а й середовище її роботи
В окремому тесті дослідники запускали ті самі моделі в різних середовищах — програмах, через які агент читає, змінює та виконує код. У масштабних переробках результат Qwen3.8-27B становив 75% або лише 56% залежно від середовища. Від того, де саме запускали моделі, залежало й те, яка з двох моделей випереджала іншу.
Тому рейтинги, де вказано лише модель, дають неповну картину. Автори радять завжди повідомляти і модель, і середовище її роботи. Компаніям, які обирають агента для кодування, варто тестувати ці компоненти разом.
У нового бенчмарку є обмеження: для кожного завдання він перевіряє один фіксований запит, не враховуючи уточнювальних запитань і виправлень від користувача під час роботи. Крім того, ШІ-оцінювачі можуть помилятися.
Дослідження організації METR уже показало, наскільки результати бенчмарків можуть розходитися з практичною придатністю. Частка коду, створеного ШІ й прийнятого керівниками проєктів, була приблизно на 24 відсоткові пункти нижчою за результати в поширеному тесті SWE-bench Verified.
Недоліки тестового середовища також можуть дати агентам змогу пройти завдання, не розв’язавши його насправді. Водночас вплив середовища неоднозначний: в іншому недавньому дослідженні агентів кодування складніші середовища майже не дали вимірюваної переваги, хоча споживали до трьох разів більше токенів.
Нагадаємо, автономні агенти можуть аналізувати запити з урахуванням контексту й адаптувати відповіді до перебігу розмови та потреб користувача.
 Ad Lucem