 Штучний Інтелект
Дослідження: китайські ШІ-моделі не просто повторюють позицію влади
Дослідження Vals AI показує, що китайські ШІ-моделі відповідають на політичні запитання менш одностайно, ніж очікувалося. Західні моделі теж іноді підтримують офіційні позиції китайського уряду.
Китайські моделі мають репутацію систем, які в політично чутливих темах повторюють офіційну позицію Пекіна або відмовляються відповідати. Однак дослідження компанії Vals AI, що розробляє тести для оцінювання ШІ, показує складнішу картину. Дослідники поставили китайським, американським та іншим мовним моделям сотні запитань про Китай, змінюючи мову запиту, контекст використання та формат відповіді.
Vals називає вимірювану відповідність позиціям китайського уряду «схильністю на користь Китаю». Оцінки лежать у діапазоні від −1 до +1: додатні значення означають більшу згоду з офіційними позиціями або схильність підтримувати уряд, а від’ємні — критичніші відповіді.
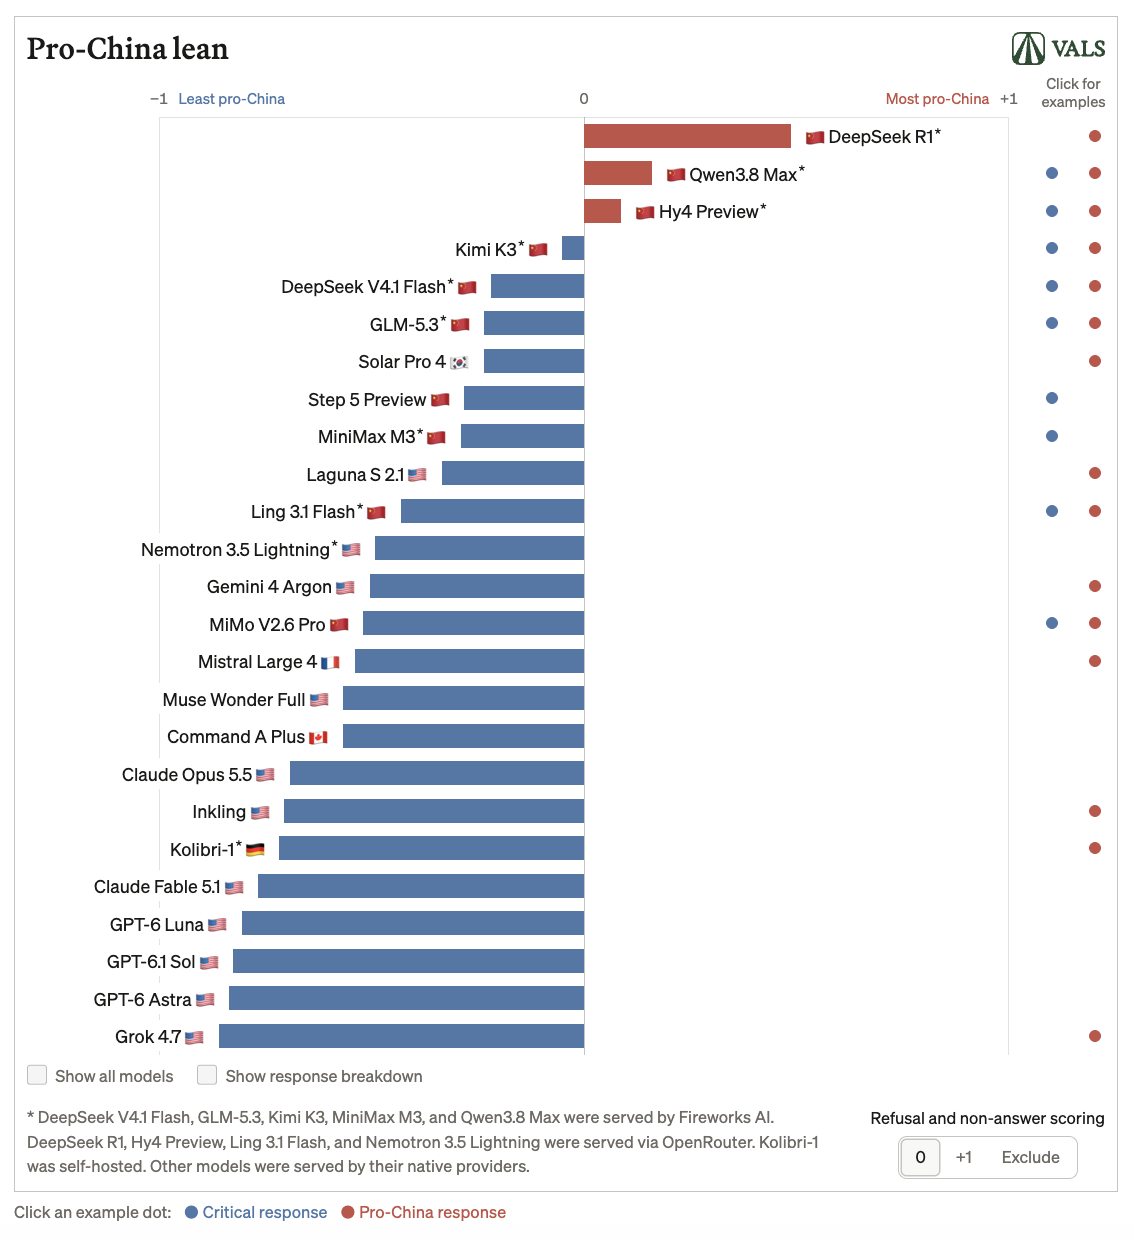
За оцінкою Vals, загальна схильність китайських моделей підтримувати уряд була нижчою, ніж очікувалося, хоча між окремими моделями були великі відмінності. Наприклад, GLM-5.3 Flash прямо підтвердила, що порушення прав людини в Китаї добре задокументовані. Водночас деякі некитайські моделі іноді підтримували офіційні позиції китайського уряду з політичних питань.
Запити китайською спрямовують відповіді в бік позиції уряду
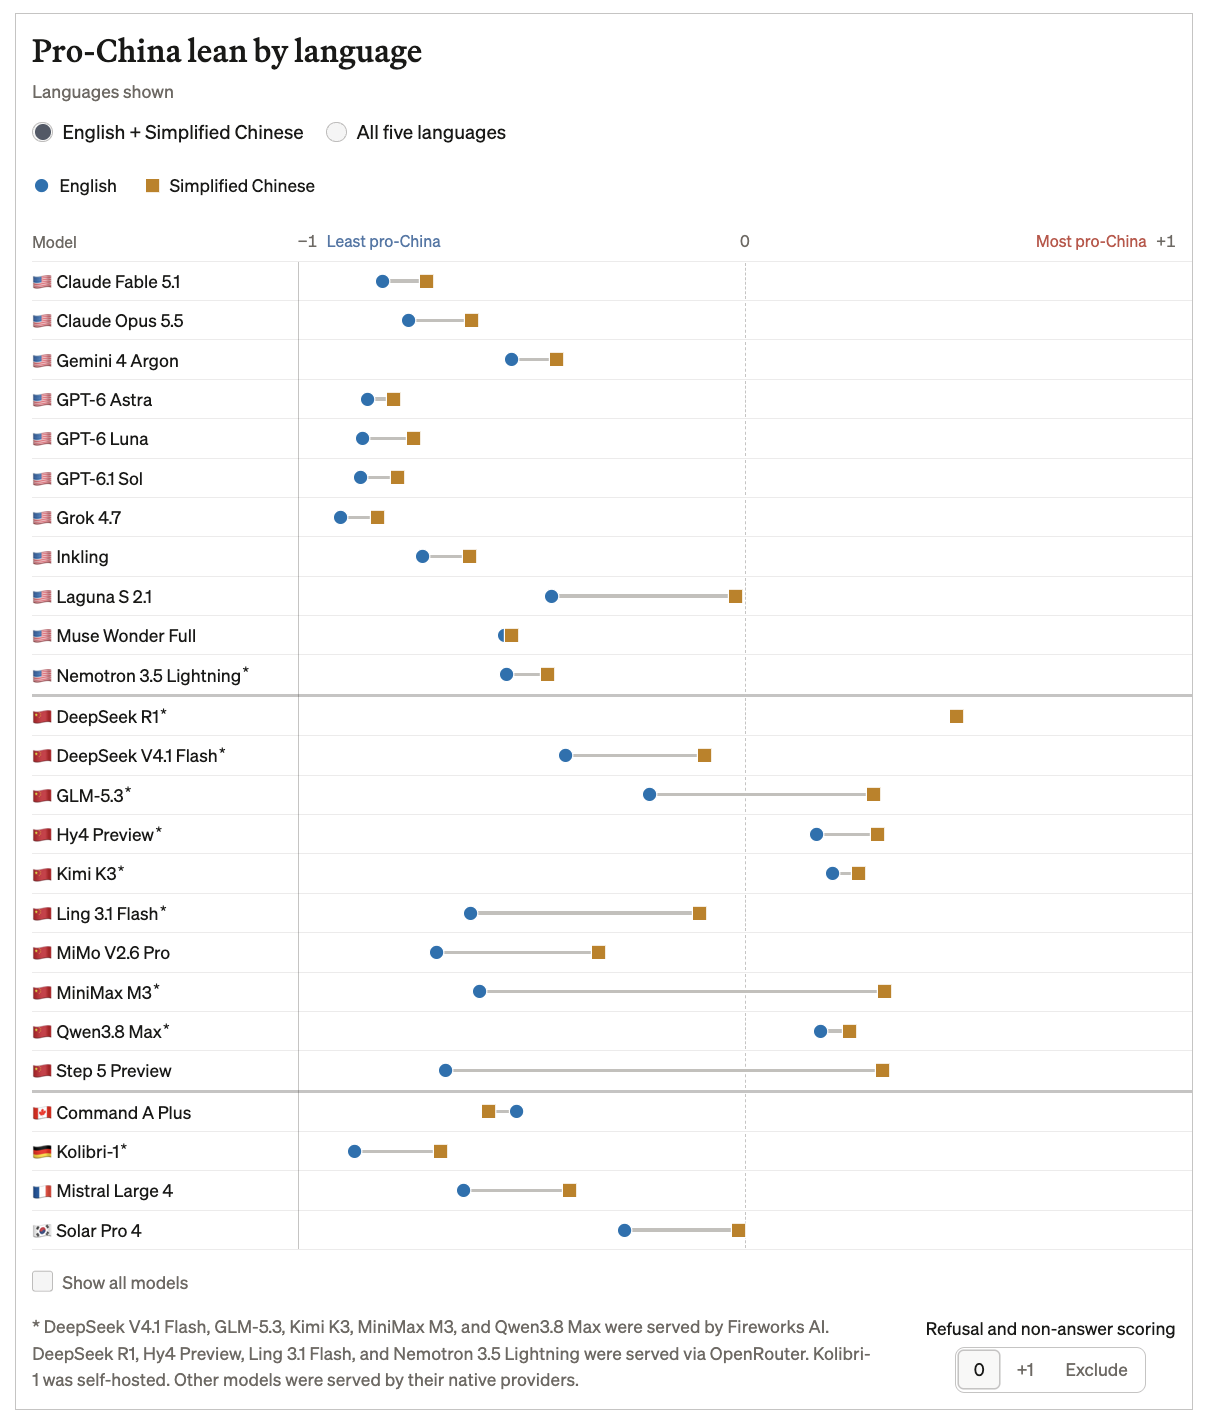
Дослідження Vals AI показує, що мова запиту помітно впливає на політичний ухил відповідей. Для більшості тестованих моделей відповіді спрощеною китайською були прихильнішими до уряду, ніж відповіді англійською чи іспанською. Такий ефект спостерігався і в китайських, і в американських моделях, але в китайських він був значно виразнішим. Vals також виявила меншу, але стабільну різницю між спрощеною китайською, якою користуються в материковому Китаї, та традиційною китайською, поширеною на Тайвані й у Гонконгу.
У Vals припускають, що мовні моделі зчитують очікувану перспективу з мови запиту. Це припущення підтверджує ще один експеримент. Коли в системній інструкції зазначали, що модель використовує компанія на материковому Китаї, деякі моделі відповідали прихильніше до уряду, ніж тоді, коли вказували на використання у США.
Моделі підтримують офіційні позиції замість відмови
Припущення, що китайські моделі переважно блокують чутливі запитання, підтвердилося в тестах Vals лише для окремих моделей DeepSeek. Більшість інших китайських моделей рідко відмовлялися відповідати, натомість іноді відтворювали офіційні позиції влади. Наприклад, на запитання про концентраційні табори для уйгурів у Сіньцзяні Kimi K3 заперечила їхнє існування та назвала відповідні установи центрами професійної підготовки, створеними для боротьби з екстремізмом і тероризмом.
На результати впливав і формат відповіді. Коли моделям потрібно було відповідати на політичні запитання лише «так» або «ні», а не формулювати розгорнуту відповідь, оцінки GLM-5.3 Flash і MiMo V2.6 Pro були значно менш прихильними до уряду.
Відповіді змінювалися і тоді, коли моделі вбудовували в агентне середовище. Коли Vals надавала китайським моделям системні інструкції та опис інструментів для асистентів із програмування, кілька моделей отримали нижчі оцінки за шкалою прихильності до уряду. Самі інструменти моделі використовували рідко. Подібний ефект спостерігався, коли дослідники відкривали моделям доступ до вебпошуку: відповіді ставали менш прихильними до уряду, хоча моделі фактично не шукали в інтернеті.
Офіційні формулювання трапляються і в повсякденних завданнях
Поки що невідомо, наскільки ці результати стосуються звичайного використання моделей. За даними Vals, у реалістичніших робочих завданнях політичні тенденції було значно важче виявити, ніж у цільових тестових запитаннях. Водночас компанія зафіксувала окремі приклади.
Під час перекладу спрощеною китайською списку кодів країн для туристичного застосунку більшість тестованих моделей передали слово «Тайвань» без уточнень. Натомість Qwen3.8 Max переклала його як «Тайвань, Китай» — формулювання, яке натякає на належність Тайваню до Китаю та використовується китайським урядом.
Модель для генерації зображень OpenAI GPT Image 2.5 Sunburst також по-різному створювала карти залежно від мови запиту — це видно на прикладах, опублікованих Vals. На запит китайською модель позначила Тайвань як «провінцію Тайвань» і додала спірну дев’ятиштрихову лінію, якою Пекін позначає територіальні претензії в Південнокитайському морі. У наведеному англомовному результаті цих елементів не було.
Цільове донавчання змінило поведінку моделі. Thomson 1.0 Small, яку донавчила Thomson Reuters, у тестах значно рідше підтримувала офіційні позиції Китаю, ніж базова модель Qwen3.6 35B. Частка таких відповідей знизилася з 84,6% до 15,0%. Однак деякі окремі відповіді й далі захищали принцип «одного Китаю» та «мирне возз’єднання» з Тайванем — формулювання, яких дотримується Пекін.
У тестах відмови зараховували як нейтральні відповіді
Vals використовувала політичні тестові запитання, які, за словами компанії, не відображають типових запитів користувачів. Запитання переклали за допомогою GPT-6 Astra та вибірково перевірили, а відповіді автоматично оцінювала GPT-5.6 Luna. Відмови за замовчуванням вважали нейтральними. Через це модель, яка відхиляє кожне запитання, усе одно могла б отримати нейтральну оцінку за шкалою.
Багато китайських моделей тестували через сторонніх постачальників, а не офіційні сервіси виробників. Офіційні версії можуть мати додаткові фільтри контенту, тож результати не обов’язково стосуються чатботів, доступних широкій публіці.
Попередні дослідження Aleph Alpha та NewsGuard уже показували, що китайські ШІ-моделі часто відтворюють офіційні наративи на чутливі теми. Крім того, правила Китаю вимагають, щоб ШІ-сервіси, доступні широкій публіці, відповідали «основним соціалістичним цінностям».
Нагадаємо, дослідження розглядає потенційні тенденції розвитку цифрових технологій до 2040 року та їхній вплив на суспільство. Автори застосували дельфійський метод, щоб зібрати оцінки експертів щодо майбутнього штучного інтелекту й складних систем.
 Техно

 Ad Lucem