 Штучний Інтелект
П’ять способів, у які спільне проєктування NVIDIA підвищує цінність кожного байта в ШІ-фабриці
В ШІ-фабриці пам’ять із високою пропускною здатністю (HBM) — найшвидший, найдорожчий і найбільш затребуваний рівень пам’яті. Кожен байт, витрачений на дубль ваг моделі, кеш KV неактивної сесії чи повторне обчислення префікса, не працює на генерацію токенів. Тепер важливо не лише те, скільки пам’яті має GPU, а й те, скільки корисної роботи виконує кожен байт.
Дані за поколіннями на рисунку 1 пояснюють чому. У NVIDIA Rubin обсяг пам’яті залишився на рівні 288 ГБ, як і в GB300, тоді як пропускна здатність зросла до 19,2 ТБ/с.
Пропускна здатність агентних навантажень на мегават зросла значно швидше. У тесті SemiAnalysis AgentX, який відтворює записані сесії кодинг-агентів із реальними паузами на виклики інструментів і контекстом, що збільшується, NVIDIA Vera Rubin NVL72 забезпечує до 30 разів більшу пропускну здатність на мегават, ніж GB300 NVL72, за швидкості 160 токенів на секунду на користувача.
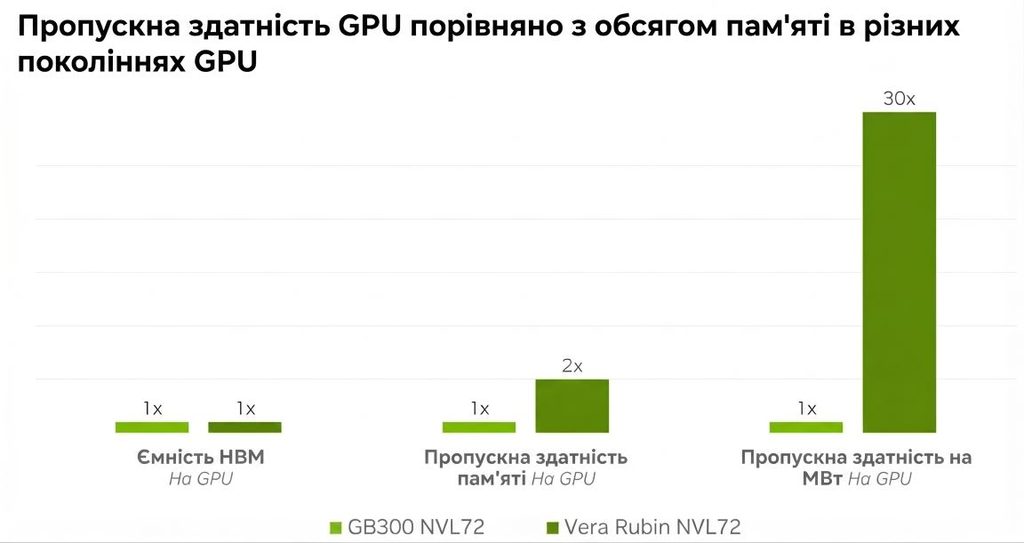
Сам обсяг пам’яті не пояснює 30-кратного приросту за однакових 288 ГБ на GPU. Різниця — у тому, скільки корисної роботи виконує кожен байт.
NVIDIA розглядає це як спільне завдання для архітектури GPU, масштабованого з’єднання, програмного забезпечення для обслуговування запитів, CPU та сховища. У матеріалі розглянуто п’ять способів підвищити цінність кожного байта пам’яті: від бітів, що кодують окрему вагу, до спільного сховища, яке зберігає та повторно використовує контекст між агентними кроками й вузлами.
1. Як NVFP4 вміщує більше інформації в меншій кількості байтів?
Найпряміший спосіб підвищити цінність байта — зменшити розмір кожного значення, не втративши закодованої в ньому інформації. NVFP4 використовує для цього 4-бітний елемент E2M1 і два рівні масштабування: кожен мікроблок із 16 значень має спільний коефіцієнт масштабу FP8 (E4M3), а для всього тензора застосовується коефіцієнт FP32. Формат дає змогу суттєво вивільнити HBM і водночас має достатню деталізацію, щоб зберігати точність там, де прості 4-бітні формати її втрачають.
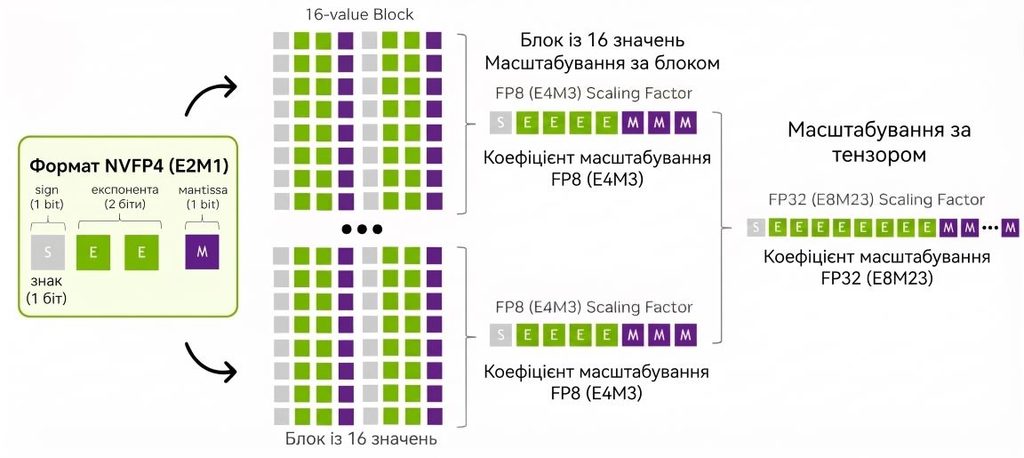
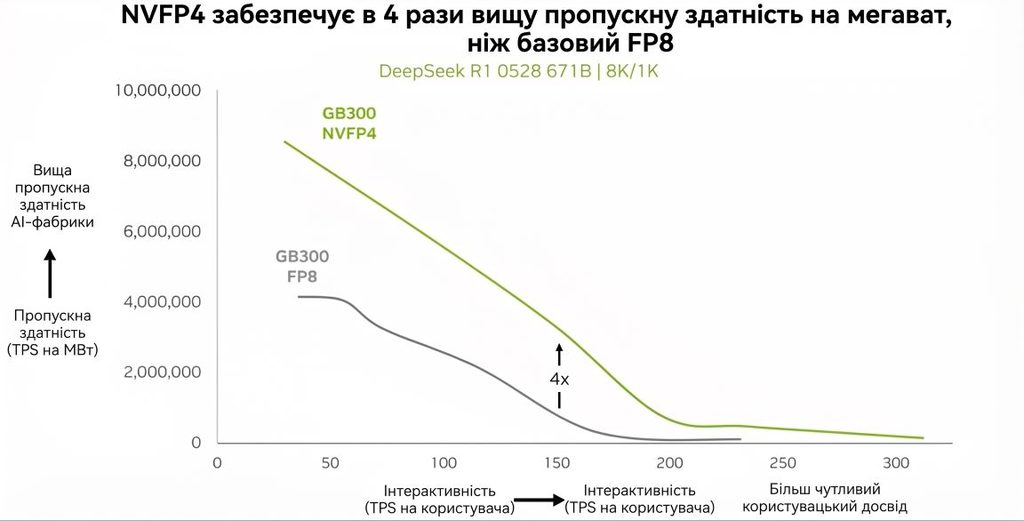
Для ваг моделі NVFP4 зменшує їхній обсяг приблизно у 3,5 раза порівняно з FP16 і у 1,8 раза порівняно з FP8. Вивільнена пам’ять дає змогу збільшити обсяг кешу KV, розмір пакетів і кількість паралельних запитів — ресурси, особливо важливі для агентного інференсу. NVFP4 став стандартною точністю для відкритих тестів агентних систем із суворими вимогами до точності, зокрема AA-AgentPerf, SemiAnalysis AgentX і MLPerf Endpoints. У цих тестах і на провідних архітектурах суміші експертів (MoE) він забезпечує до чотириразової пропускної здатності порівняно з базовим варіантом FP8 за однакового рівня інтерактивності (рисунок 3).
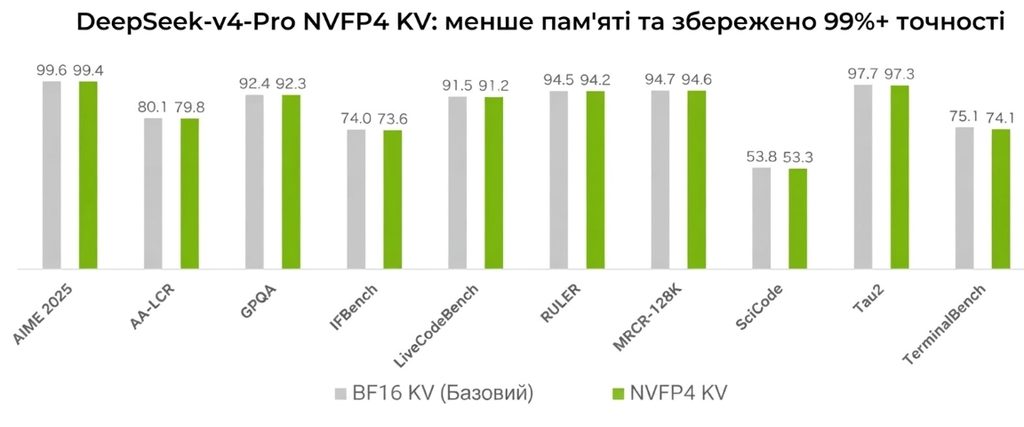
Цей принцип поширюється і на сам кеш KV. NVFP4 зменшує його обсяг до 50% порівняно з FP8, тож на пристрої може залишатися приблизно вдвічі більше контексту. Менше витіснень підвищує частку влучань у кеш під час prefill, а менший кеш споживає менше пропускної здатності під час decode.
NVFP4 зменшує кількість байтів. Наступне питання — де вони зберігаються і скільки копій цих даних має підтримувати ШІ-фабрика.
2. Як домен масштабування NVLink об’єднує 72 GPU в один пул пам’яті?
Моделі MoE активують лише частину параметрів для кожного токена, але ваги всіх експертів однаково мають десь зберігатися в HBM. Якщо експертів розмістити на невеликій кількості GPU, значну частину пам’яті кожного з них займуть ваги, а кожен крок decode потребуватиме великих витрат на завантаження ваг для операцій MoE GroupGEMM. Байти є в пам’яті, але використовуються неефективно.
Широкий паралелізм експертів (Wide-EP) у NVIDIA TensorRT-LLM змінює це співвідношення, розподіляючи експертів між вісьмома або більшою кількістю GPU. Для DeepSeek-R1 з EP64 на кожному GPU розміщено по чотири експерти на шар — загалом 232 блоки експертів у 58 шарах MoE із 14 848 блоків у повній моделі. Менша кількість ваг експертів на GPU дає такі переваги:
- Ємність: на кожному GPU залишається більше HBM для кешу KV, більших пакетів і більшої кількості паралельних запитів.
- Арифметична інтенсивність: ядра GroupGEMM повторно використовують кожну завантажену вагу для більшої кількості токенів, збільшуючи кількість FLOPs на байт.
- Балансування: Expert Parallel Load Balancer (EPLB) перерозподіляє популярних і менш затребуваних експертів між прямими проходами, щоб пам’ять жодного GPU не була перевантажена, поки інший простоює.
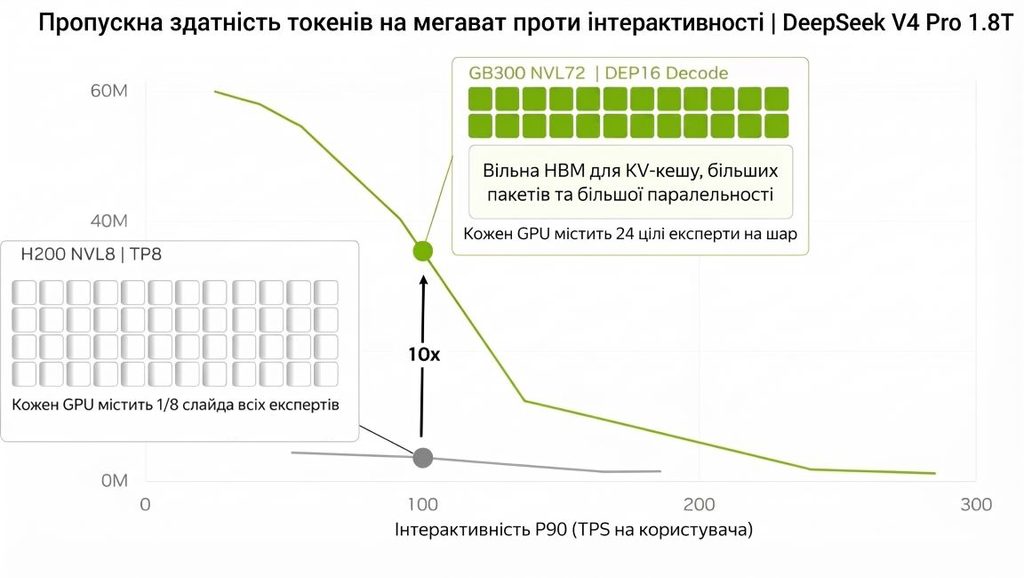
Це працює лише тому, що в межах домену масштабування віддалені байти майже такі ж корисні, як локальні. Кожен шар MoE спричиняє трафік обміну all-to-all для розподілу та об’єднання даних. Без високошвидкісної мережі ці колективні операції нівелювали б переваги. У GB200 NVL72 сукупна пропускна здатність NVLink у 130 ТБ/с забезпечує цей трафік, а великий EP (EP32) дає до 1,8 раза більше вихідних токенів на секунду на GPU, ніж малий EP (EP8), за швидкості 100 токенів на секунду на користувача.
Vera Rubin NVL72 розвиває той самий підхід. Кожен GPU Rubin має до 288 ГБ HBM4 і пропускну здатність NVLink 6 до 3,0 ТБ/с; загалом у стійці — близько 20,7 ТБ HBM4. У Rubin також додано оновлення дескрипторів inline memory tensor accelerator (TMA): один спільний дескриптор може обслуговувати всі експерти зі спільним розташуванням даних, зменшуючи накладні витрати на метадані, що зростають зі збільшенням кількості експертів.
Wide-EP визначає, де зберігаються байти ваг. Наступний інструмент вирішує, чи доведеться повторно обчислювати байти кешу KV після того, як їх уже було створено.
3. Як NVIDIA Dynamo допомагає використовувати кожен байт кешу?
Кеш ключів і значень (KV) зберігає проміжні обчислення механізму уваги для вже оброблених токенів, щоб модель могла їх повторно використати, а не обчислювати заново. Цей стан інференсу тимчасовий: його можна витіснити й за потреби обчислити повторно. Але кеш KV цінний лише тоді, коли його повторно використовують. В агентних навантаженнях для цього є багато можливостей: системні промпти, схеми інструментів, спільні документи й історія багатокрокового завдання, що постійно зростає. Однак якщо запит потрапляє на GPU, де немає потрібного префікса, або його щойно було витіснено, системі доводиться знову виконувати prefill. Байти були в системі, але не там, де потрібно.
Цю проблему розв’язує розподілений рівень обслуговування запитів NVIDIA Dynamo. Він розглядає кеш KV як ресурс усього кластера, а не побічний результат роботи окремого GPU. Для цього поєднано три можливості:
- Маршрутизація з урахуванням KV: маршрутизатор Dynamo відстежує розташування блоків KV і під час призначення запитів враховує збіг із кешованим префіксом та завантаження робочих вузлів. Він балансує між повторним використанням наявного контексту та витратами на передавання завдання завантаженому GPU, перетворюючи потенційні повторні обчислення на влучання в кеш.
- Розділене обслуговування: prefill і decode виконуються на окремих пулах GPU, кожен із яких налаштовано відповідно до власних вимог до обчислень і пам’яті. GPU для decode можуть відводити HBM під кеш KV і розмір пакета, а не резервувати запас пам’яті для нерівномірного навантаження prefill.
- KV Cache Runner (KVCR): відстежує розташування кожного блока на налаштованих рівнях — у пам’яті GPU, закріпленій пам’яті CPU та сховищах, зокрема локальних SSD і змонтованих мережевих файлових системах. Префікс, збережений поза HBM, можна відновити для наступного запиту: корисний контекст переживає витіснення з GPU й надалі дає змогу уникнути повторного prefill. Для передавання даних зі сховищ KVCR використовує NVIDIA Inference Xfer Library (NIXL), тож кешовані блоки можна переміщувати, поки GPU виконує іншу роботу. KVCR також підтримує розподілене повторне використання: підказки від маршрутизатора допомагають вибраному робочому вузлу отримати кешований контекст від іншого, а механізм інференсу зберігає контроль над пам’яттю GPU та локальним перенесенням даних на хост. Додаткова функція KVCR-Guard зберігає зафіксований у кеші хоста стан, яким керує KVCR, у разі збою механізму інференсу, якщо служба Guard і хост залишаються доступними.
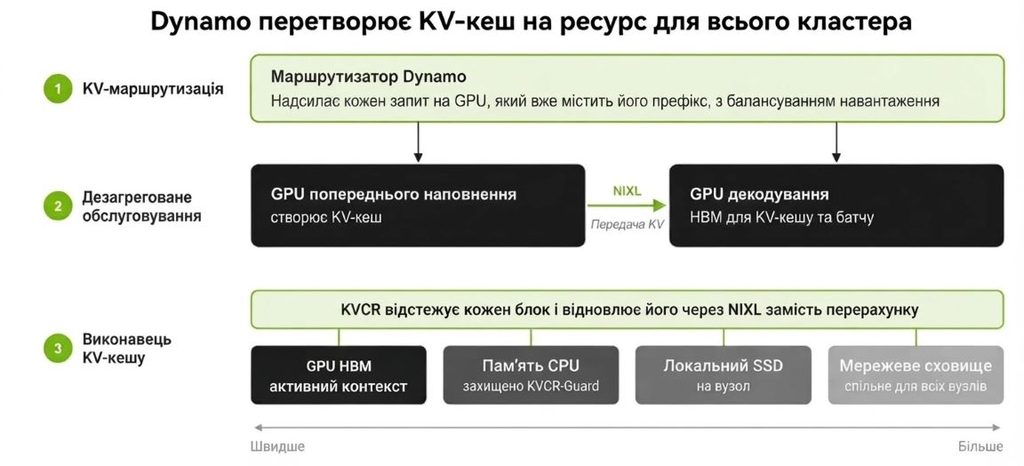
Вивантаження кешу KV у Dynamo залежить від швидкого отримання даних: збереження префікса поза HBM заощаджує час, якщо його завантажити швидше, ніж повторно виконати prefill. NIXL з’єднує цей шлях вивантаження із зовнішніми системами зберігання. В окремих тестах постачальники сховищ VAST Data і WEKA показали відповідно 35 ГБ/с для одного GPU H100 із GPUDirect Storage та до 270 ГБ/с сукупної пропускної здатності читання для восьми GPU H100 через спеціальний плагін NIXL. Тести засвідчили, що зовнішнє сховище може постачати кеш KV перевіреним системам GPU, не стаючи вузьким місцем передавання, і забезпечувати ємність кешу понад обсяг HBM. В окремому тесті VAST також показала скорочення часу відгуку: на системі DGX H100 із vLLM і LMCache завантаження збереженого кешу KV замість його повторного обчислення зменшило час до першого токена для Qwen3-32B із промптом на 130 тисяч токенів.
Dynamo координує, куди потрапляють кешовані байти та коли їх потрібно повернути. Наступні два інструменти збільшують доступний для контексту обсяг пам’яті, починаючи з пам’яті CPU.
4. Як CPU NVIDIA Vera не дає контексту неактивних сесій марно займати HBM?
Агентний інференс не відбувається одним безперервним циклом. Одна сесія чергує кроки моделі на GPU з роботою на CPU: викликами інструментів, виконанням коду, пошуком даних, запитами до баз даних і запуском у ізольованому середовищі. Під час кожної такої паузи кеш KV сесії, якщо він залишається в HBM, займає пам’ять, хоча генерація токенів не відбувається. Тим часом за ті самі байти конкурують інші запити.
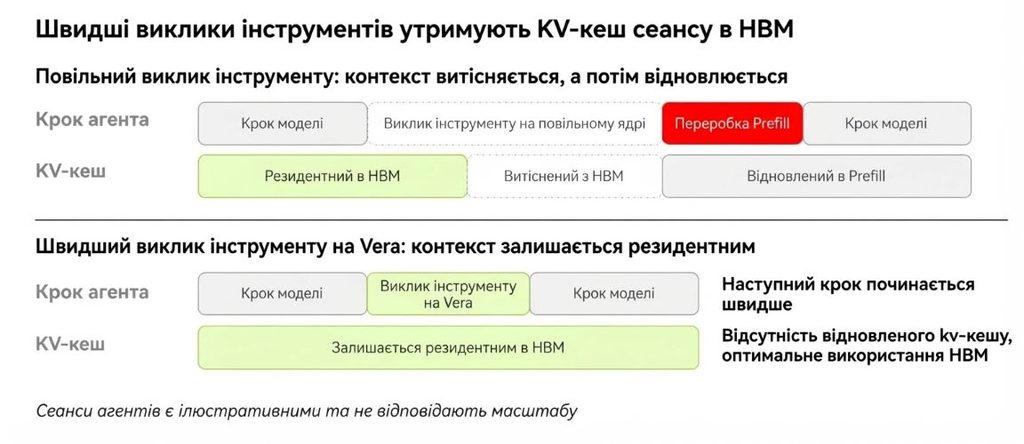
У повністю завантаженій ШІ-фабриці GPU не простоює: поки виконується виклик інструмента, він обробляє нові запити. Що довша пауза, то вища ймовірність, що кеш KV початкової сесії витіснять, щоб звільнити місце. Коли інструмент повертає результат, GPU може знадобитися заново побудувати контекст за допомогою повного prefill, а не продовжити роботу з кешованого стану. Тому повільний CPU двічі збільшує витрати HBM: спочатку пам’ять зайнята неактивними даними, а потім потрібні повторні обчислення.
CPU NVIDIA Vera зменшує обидва види витрат:
- Коротші паузи: 88 ядер Olympus забезпечують у 1,8 раза вищу однопотокову продуктивність, на 40% нижчу пікову затримку під повним навантаженням порівняно з x86 CPU та до 14 ГБ/с пропускної здатності пам’яті на ядро. Швидші й передбачуваніші виклики інструментів скорочують проміжок, коли кеш KV зазнає тиску через можливе витіснення.
- Швидкий рівень для тимчасового зберігання контексту: кожен CPU Vera має до 1,5 ТБ LPDDR5X — більш ніж у п’ять разів більше, ніж HBM4 в одному GPU Rubin. NVIDIA NVLink-C2C забезпечує когерентне з’єднання з Rubin зі швидкістю 1,8 ТБ/с — приблизно у сім разів більше, ніж 256 ГБ/с у з’єднання x16 PCIe Gen 6.
Разом ці можливості змінюють витрати на обслуговування неактивної сесії. Замість того щоб тримати її кеш KV в HBM або відкидати його, KV Block Manager у Dynamo може тимчасово розмістити кеш у пам’яті Vera на час виклику інструмента, а коли агент відновить роботу — повернути його через NVLink-C2C. HBM залишається для сесій, які активно генерують токени, а призупинена сесія уникає повторного prefill.
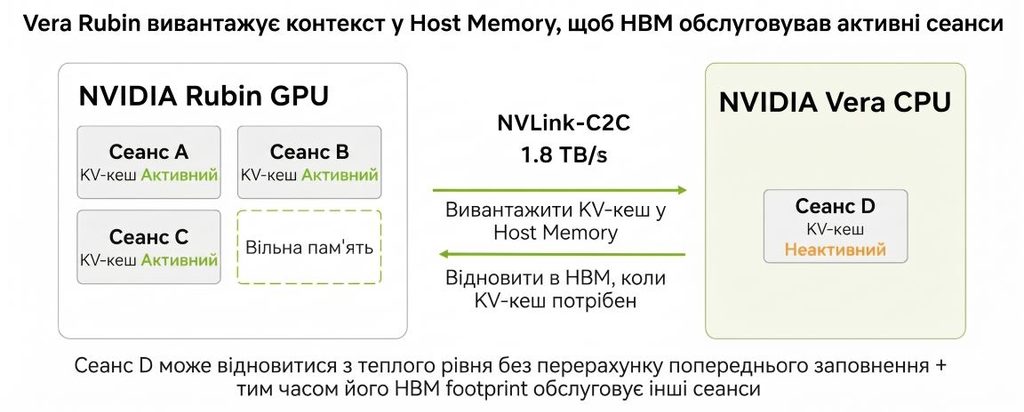
Пам’ять Vera — це швидкий проміжний рівень для контексту, який знадобиться знову в межах одного кроку. Для контексту, що має зберігатися між кроками, агентами й вузлами, ШІ-фабриці потрібен ще місткіший рівень.
5. Як NVIDIA CMX розширює пам’ять для контексту на рівні пода?
Зберігання всіх байтів кешу KV, які можна повторно використати, у пам’яті GPU або хоста обмежує ресурси для активного інференсу. Але якщо відкидати цей кеш, дані доведеться обчислювати повторно. Багатокрокові сесії, довготривалі завдання й робочі процеси з кількома агентами, які спільно використовують робочу пам’ять, створюють кеш KV, потрібний знову — часто за кілька хвилин і нерідко на іншому вузлі. Довші контекстні вікна й більша кількість одночасних сесій підвищують вимоги до місткості кешу KV понад обсяг HBM GPU (G1 на рисунку 9) і пам’яті хоста (G2). Традиційна ієрархія не була розрахована на ці дані. Локальні SSD (G3) прив’язані до одного вузла, а спільні корпоративні сховища (G4) призначені для довготривалих даних і мають накладні витрати на реплікацію та метадані, непотрібні для тимчасового кешу KV.
Сховище контексту NVIDIA CMX закриває цю прогалину новим рівнем G3.5: флеш-пам’яттю, під’єднаною через Ethernet, спільною для всього пода й оптимізованою для кешу KV. Рішення побудовано на референсному дизайні NVIDIA STX і спільно розроблено на чотирьох рівнях:
- Оброблення даних у сховищі: процесор NVIDIA BlueField-4 STX керує SSD NVMe, запускає служби сховища та бере на себе переміщення даних кешу KV, контроль цілісності й шифрування. Інтегрований CPU NVIDIA Vera прискорює оброблення даних на CPU, поширюючи ту саму архітектуру, що використовується для виконання агентних завдань, на шлях передавання даних у сховищі.
- Мережа: NVIDIA Spectrum-X Ethernet забезпечує низьку затримку й високу пропускну здатність RDMA-з’єднання між обчислювальними вузлами та вузлами сховища CMX.
- Служби з урахуванням KV: NVIDIA DOCA Memos на BlueField-4 надає служби, що враховують KV, і керує операціями введення-виведення, розглядаючи контекст як окремий ресурс для розміщення та спільного використання.
- Інтеграція з обслуговуванням запитів: Dynamo і NIXL створюють єдиний рівень контексту CMX для всього пода, попередньо розміщують контекст і спрямовують запити туди, де вже зберігається кеш KV.
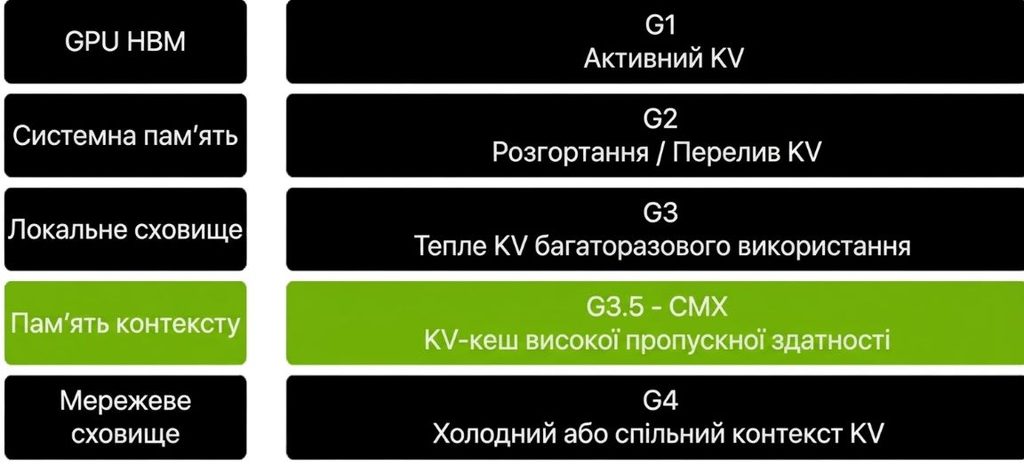
Саме спільний рівень пода підвищує цінність кожного байта. Префікс, обчислений один раз на одному вузлі, можна повторно використати на сумісних екземплярах моделі в поді. Тож агенти, які працюють зі спільними документами, інструментами чи робочою пам’яттю, можуть уникнути дублювання prefill. Об’єднання сховищ контексту в межах пода зменшує дублювання кешу KV і невикористану місткість на вузлах, збільшуючи ефективний обсяг пам’яті GPU для інференсу. Попереднє розміщення контексту, який можна повторно використати, у пам’яті GPU або хоста зменшує затримки інференсу, а рівень сховища, оптимізований для кешу KV, знижує енергетичні витрати на обслуговування цього контексту. Разом ці можливості дають змогу CMX забезпечувати до п’яти разів більшу пропускну здатність у токенах за секунду та до п’яти разів кращу енергоефективність порівняно з традиційними сховищами для інференсу з довгим контекстом.
Як працюють разом усі п’ять інструментів?
Кожен інструмент усуває окремий вид втрат. NVFP4 прибирає зайві біти в представленні значень, Wide-EP — дубльовані копії ваг, Dynamo — повторні обчислення, Vera — неактивне перебування даних у пам’яті під час викликів інструментів, а CMX забезпечує спільне використання й повторне використання кешу KV між вузлами. Оскільки ці інструменти спроєктовано як єдину систему пам’яті, а не як незалежні компоненти, їхні переваги підсумовуються: 4-бітний блок KV заощаджує місце в HBM, пам’яті Vera та CMX.
У результаті ШІ-фабрика оцінює пам’ять не лише за її місткістю, а й за кількістю корисних токенів, яку генерує кожен байт. Vera Rubin NVL72 демонструє цей підхід: до 30 разів більша пропускна здатність на мегават, ніж у GB300 NVL72, за однакових 288 ГБ на GPU. Із розвитком агентних навантажень важливим стає кожен байт.
Цей матеріал підготовлено за участі фахівців і інженерів Вей-мін Чена, Шиян Чена, Чао Ні, Менді Ван і Джеффа Пула.
Нагадаємо, Nvidia представила архітектуру OpenShell Reference Architecture, призначену для безпечної ізоляції, контролю та моніторингу автономних ШІ-агентів під час виконання завдань.
 Ad Lucem